はじめに
ROIS-DS人文学オープンデータ共同利用センター/国立情報学研究所の北本朝展氏が、DHコンソーシアムプロジェクト(DiHuCo)の研究実践ハブで進める地理・地誌データの公開を紹介した講演です。地図・地誌・地名という三つの枠組みに沿って、江戸時代から現代までを対象とする各種データセットの設計、識別子(ID)の付与方針、古地図や古写真を扱う手法、それらを歴史研究に応用する試みを取り上げます。
DiHuCo研究実践ハブと地図・地誌類領域
ROIS-DS人文学オープンデータ共同利用センター(CODH)はDiHuCoの中で地図・地誌類領域の人文DXを担当しており、北本氏はそのなかで、現代地名ではなく歴史地名への識別子付与に重点を置く方針を示しました。
DiHuCo(DHコンソーシアム)は、文科省「人文学・社会科学のDX化に向けた研究開発推進事業」の中で2024年12月から動いているプロジェクトです。CODHは研究実践ハブで、DHユースケースの開発やガイドラインの執筆などを担当しています。北本氏はこの講演を二部構成とし、前半で地理・地誌データの公開を、後半でAgentic Publishingによるガイドライン構築を扱いました。
歴史地名に重点を置くのは、現代地名には産業的なニーズがあるため自分たちが取り組まなくても整備が進む一方、歴史地名は取り組む人が少なくなかなか進まないからです。
地図・地誌・地名の枠組みと識別子付与の方針
北本氏は、地理に関係する情報を地図・地誌・地名の三つに分けて整理したうえで、地名に識別子(ID)と属性を与えるという方針を示しました。
地理空間にあたる地図はポイントやポリゴンなどの幾何的なデータ、情報空間にあたる地誌はテキストや画像などのメディアデータです。地誌では地理情報が地名として言及されることが多く、地名は地図上に表示でき、文章中でも言及できるエンティティ(実体)です。北本氏は、地名にIDを付与して一元管理することが望ましいとしました。
識別子の付与では、何を同じエンティティとみなすかという判断基準が問題になります。たとえば東京が指すものは、東京市15区から35区を経て現在の23区へと時代によって変わり、東京府と東京都でも異なります。これらを同じ東京とみなすかはどちらの立場も取りうるため、あらかじめ基準を決めていく必要があります。
属性の付与では、地図上に表示したいという目標が強いため位置情報が特に重要ですが、どこを代表点として選ぶかという難しさが伴います。名称の表記揺れや粒度の相違の吸収、よみや基本統計の付与も必要です。こうした識別子と属性の組をデータセット化し、実世界との紐づけとデータ統合に利用します。
地名のデータセット:行政区域から近世村へ
北本氏は、現代から江戸時代へとさかのぼる形で、行政区域、地名項目、施設・地点項目、近世村という四つの地名データセットを構築してきました。
歴史的行政区域データセットβ版は、国土数値情報と複数のオープンデータを統合したデータセットで、1920年以降の市区町村に網羅的にIDを付与しています。内訳は市区町村コード(XXXXXAYYYY)が4159件、国土数値情報(PPBQQQRRRR)が12234件、行政界変遷DB(PPCQQQRRRR)が336件で、合計16729件です。たとえば八王子市の市区町村IDは13201A1968です。その範囲は合併によって広がってきましたが、同じ名称のものを同じエンティティとして統合しているため、資料中に八王子市が現れたときにこのIDと結びつけ、何年の資料かで範囲が変わることを確認できます。この系列を過去へ延ばす作業も進めており、1919年から1889年(市制及町村制)への遡及と、明治時代(1888年以前)から江戸時代への遡及が課題です。
江戸時代へさかのぼる際の重要な情報源が、平凡社『日本歴史地名大系』です。『日本歴史地名大系』地名項目データセットは、『日本歴史地名大系』の地名項目に位置情報を加えて機械可読データ化したもので、江戸時代の村までさかのぼる80,502件の地名データをCC BYライセンスで公開しています。北本氏はこれを、地名のリストは公開する一方で解説部分は公開対象としないという、出版社と協力した学術情報のオープン・クローズ戦略として位置づけました。『日本歴史地名大系』施設・地点項目データセットは、同じ資料の施設・地点(POI)項目を機械可読データ化した32,038件で、こちらもCC BYライセンスで公開し、今後もアップデートする計画です。
幕末期近世村領域データセットは、幕末期近世村66,581件の領域データと点データを収めたもので、本田謙一氏が作成したデータです。近世村の境界は簡単には分からないため、現代の農業集落境界データを用いています。現代の農業集落と江戸時代の村にはそれなりの連続性があるだろうという前提に立った代用であり、完全に同じものではありません。石高には歴博の旧高旧領取調帳データベースを用いており、どの村でどれだけの米が取れ、どの領主に年貢を納めたかを組み合わせると、村と領主の帰属関係が見えます。
地名のデータセット:藩・街道・宿場とGeoLOD
藩・街道・宿場にもIDを付与し、それらを登録・共有する基盤としてGeoLODを整備しています。位置が一意に定まらない場合には、曖昧さをID自体に含める工夫も導入しました。
藩IDデータセットは、江戸・明治時代の藩として408藩に識別子(ID)を付与し、藩名と別名も定義したものです。ただし、408という数字は藩の定義次第で変わりうるものであり、名称もデータセットの基準で決めたものです。理由として挙げたのは、江戸時代に幕府が藩を公式に定めていたわけではなく、実体としてあったのは大名家だったという事情です。
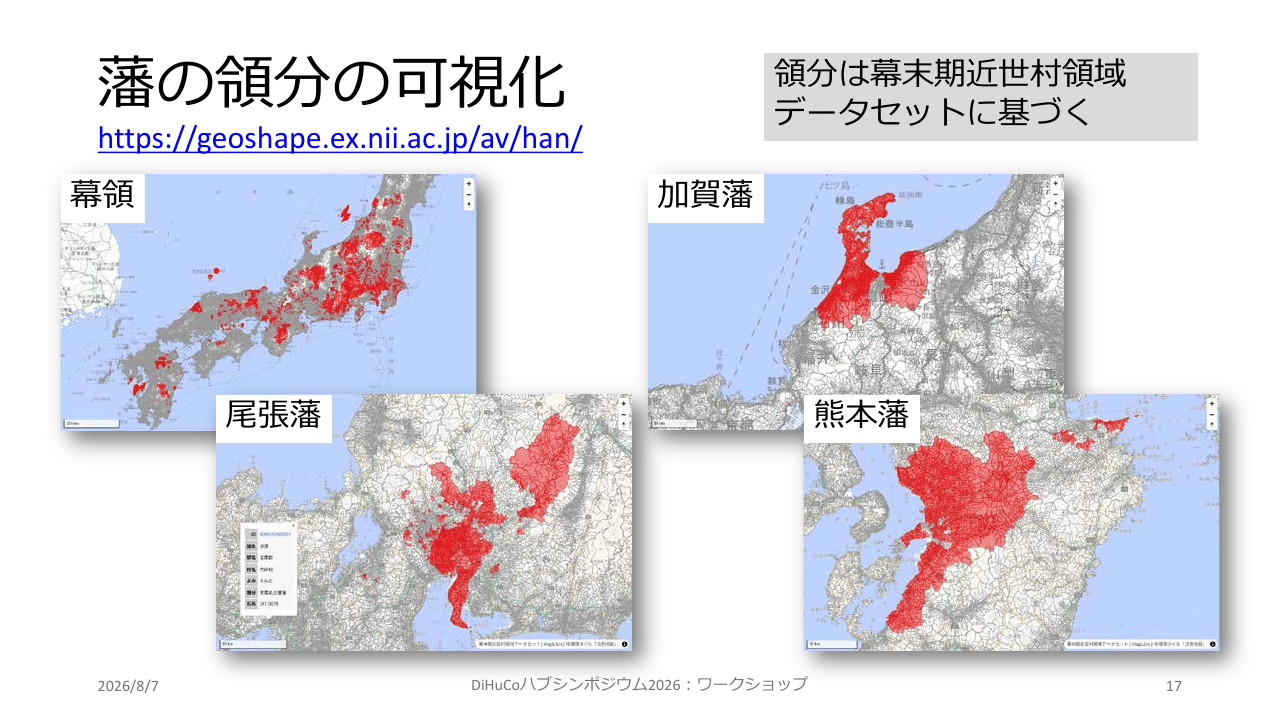
位置情報は藩代表点(居城・陣屋)データセットで付与します。陣屋は城ではなく小さな建物で痕跡が消えやすいため、小さい藩ではどこにあったのかが分からない場合があります。『日本歴史地名大系』とは大部分がリンク済みです。また幕末期近世村領域データセットと連携すると、藩の領分を地図上に可視化でき、幕領、加賀藩、尾張藩、熊本藩の例では領分が必ずしもひとまとまりではなく分散していることが分かります。
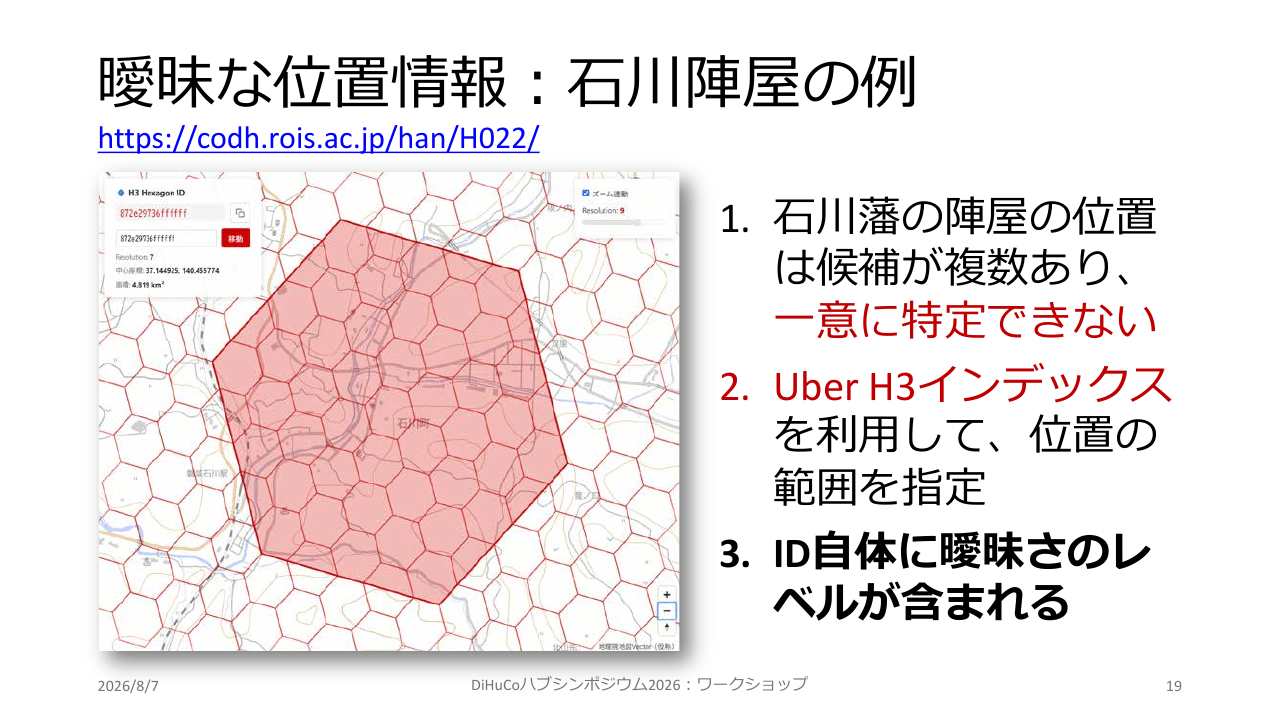
一方、位置を決めることが難しい場合もあることがわかりました。その一つの例が石川藩の陣屋で、候補が複数あり一つに決められません。そこでUber H3インデックスを利用し、六角形で位置の範囲を指定します。このIDは場所と六角形の大きさを一つの文字列で同時に指定できるため、ID自体に曖昧さのレベルが含まれます。
江戸主要街道データセットは、江戸時代の主要街道(五街道および主要脇街道)の道路データで、総延長は8360kmです。街道IDは五街道だけ一桁、その他は地域ごとに三桁の番号を付与します。江戸宿場データセットは、『日本歴史地名大系』の宿場データを街道ID毎にリスト化し、宿場IDを付与したものです。東海道品川宿の場合はR001-002となり、移動を宿場ID間の経路として表現できます。ただし北本氏は、宿場IDの付与は進行中でまだ全部はできていないと述べています。こうして付与したIDはGeoLODに登録します。GeoLODは地名データセットに地名IDを付与するシステムで、属性表示や検索をウェブとAPIから利用でき、オンラインで地名辞書を構築・共有する機能も提供しています。
地図のデータセットと古地図の活用
地図(地理空間)の側では、江戸時代の海岸線や湖沼のデータ、古地図から地名を抽出したデータセットを整備し、古地図を現在の地図に重ね合わせる作業を進めています。
江戸末期海岸線/水域データセットと江戸末期湖沼データセットは、複数資料を基に人手で構築したデータをGeoJSON形式で公開したものです。海岸線は江戸時代と現在で大きく異なり、資料に登場する人物が海沿いを歩いたのかどうかの判断にも関わります。湖沼についても、当時は大きな湖だった場所が現在は埋め立てられている場合、景観は大きく変化しています。なお、海岸線や湖岸線に関しては、資料に情報がそろっているわけではないため、複数の資料を組み合わせて補ったり、不足している部分を推定したりしながらの作業になります。
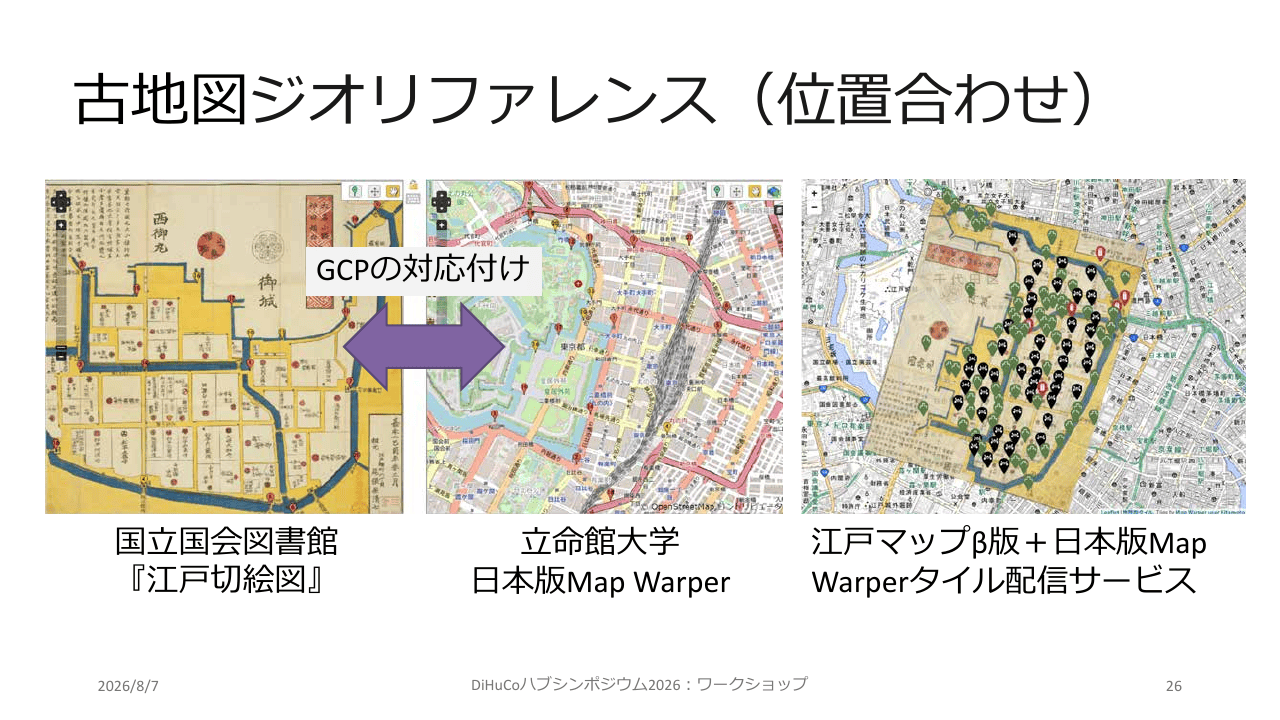
江戸マップは、29枚の古地図『江戸切絵図』から8788ヶ所の地名を抽出してデータベース化したものです。現在は使われていない地名は現代の地図サービスでは分からないため、古地図から拾ってデータ化する作業が重要です。活用には現在の地図との位置合わせ(ジオリファレンス)が必要ですが、古地図には北を上にするルールがなく描きたい方向で描かれており、多くの地点を地図に入れるために距離を圧縮して描いているため、回転だけでは合わず、歪みも補正しながら重ね合わせます。この作業では国立国会図書館『江戸切絵図』を対象に立命館大学の日本版Map Warperを利用しています。ただし歪みの大きい箇所は全体の重ね合わせでは合わないため、地名を一つずつ現在の場所に対応づけ、29枚分をマッピングして全体像を得ています。
れきちずは現代風デザインのWeb歴史マップで、株式会社MIERUNEが運営し、CC BY-NC-NDで提供されています。日本全国をシームレスに表示でき、道路や海岸線から描き直されているため、その上に歴史的情報を重ねると街道や川などとの関係が解釈しやすくなります。実際に江戸時代の商店の分布を重ねると、町の領域に店が集まる傾向が読み取れます。
地誌を扱うツールと地理情報の記述
地誌(情報空間)の側では、資料から住所や地名を取り出して位置情報へ変換するツール、それを資料に記述するための規格、位置情報を持たない古写真の撮影地を同定する手法を取り上げます。
歴史的ジオコーダーは、Python版ジオコーダーjageocoder(開発:情報試作室 相良毅氏)を利用し、現代の住所を高速に緯度経度へ変換します。旧東京市15区住所データセットなどを使えば過去の住所も変換でき、旧東京市15区住所マップは56,089件の住所をポリゴン・ポイントデータに変換したうえで、入力した住所の結果を代表点とポリゴンで表示します。たとえば鹿鳴館は東京府東京市麹町区内山下町にあたります。元データは東京都立大学で作成されたもので、利用許諾を得て活用しています。GeoNLPは、テキスト中の地名と住所を自動的に抽出して辞書中の地名とリンクするソフトウェアで、住所部分のエンジンにはjageocoderを利用し、地名辞書を拡張すれば適用範囲を増やせます。
地理情報を資料に記述する規格として、北本氏はTEI(Text Encoding Initiative)とIIIF(International Image Interoperability Framework)を取り上げました。TEIはXMLの世界の規格で、場所を表すのにplaceタグを利用し、GML(Geography Markup Language)を使えばポリゴンも表現できます。一方、画像を共有する枠組みとして広く使われているIIIFはJSONの世界の規格で、場所を表すのにnavPlaceを利用します。navPlaceに対応するIIIF Curation Viewerの利用例が華北交通アーカイブで、写真メタデータの駅情報から駅の緯度経度を推定してIIIFマニフェストに埋め込み、画像を閲覧したときに場所を地図上で確認できるようにしました。
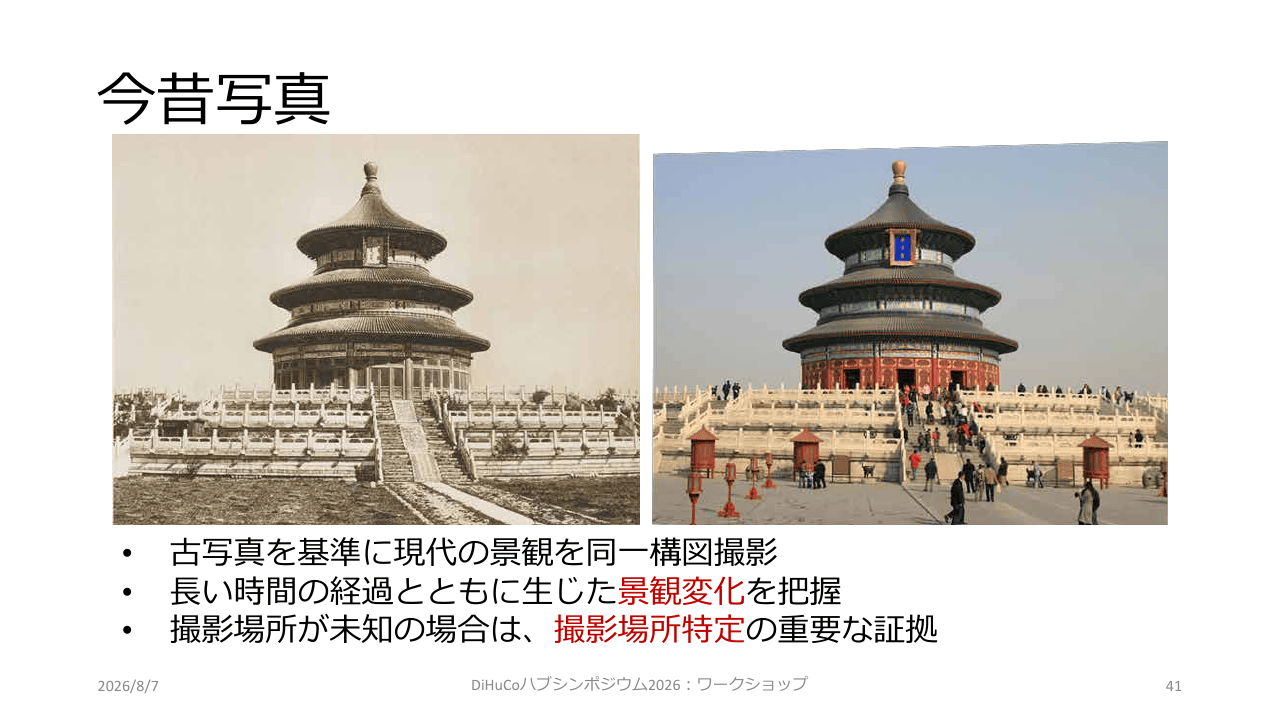
位置情報を持たない古写真については、同じ構図の写真を撮れる場所を探せば撮影地を同定できるという発想から、メモリーグラフを開発しました。スマートフォンの画面に古写真を表示し、カメラのファインダー上で現在の景観と重なる場所を探す仕組みです。同一構図で撮影すれば長い時間の経過による景観変化を把握でき、撮影場所が未知の場合には特定の重要な証拠になります。災害等で生じた非連続的な変化の前後の写真を選べば、被害の大きさや復旧・復興も可視化できます。
デジタル歴史研究基盤に向けた応用
これらが向かう先として、北本氏は歴史ビッグデータの統合解析によるデジタル歴史研究基盤という構想を示しました。
歴史的資料(史料)から、気候・地震・噴火・疫病といった自然科学的データと、経済・人口・政治・文化といった人文社会的データを取り出し、データ構造化ワークフローで機械可読データにするものです。
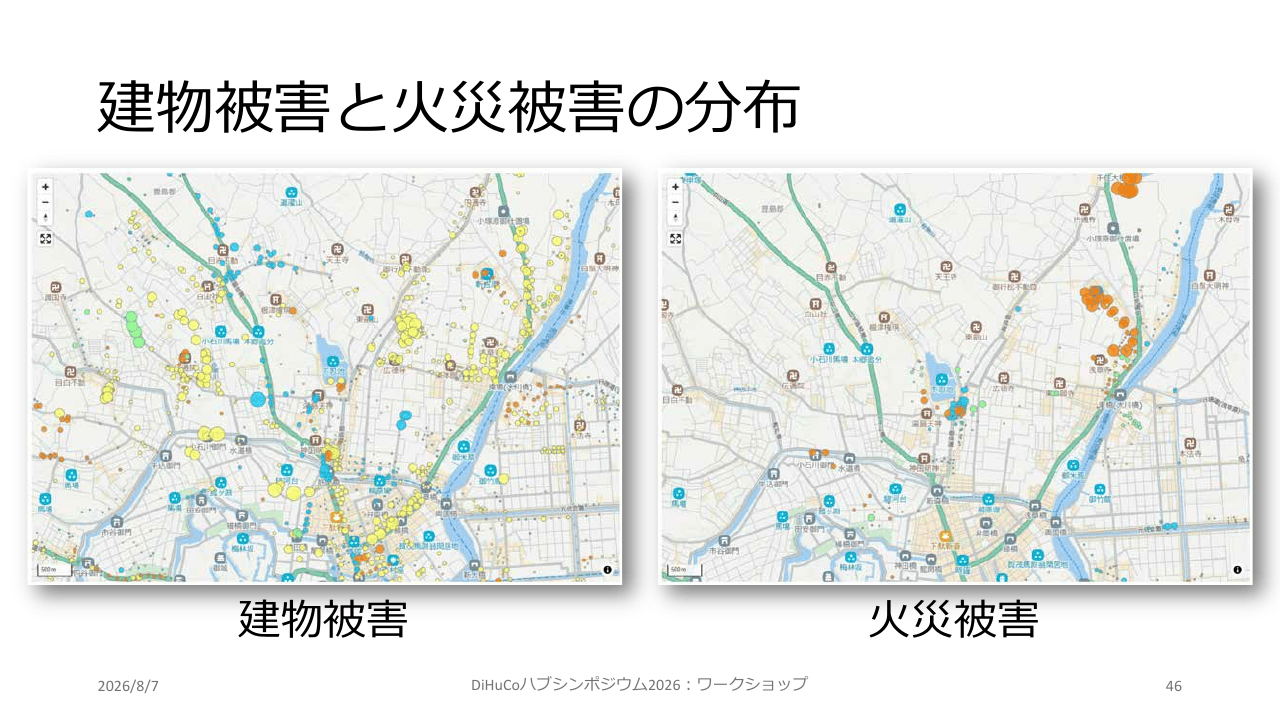
応用の一つが安政江戸地震です。安政2年10月2日(1855年11月11日)午後10時頃に発生し、江戸市中の死者数は1万人前後とされます。みんなで注釈【安政江戸地震史料】プロジェクトで、すでに注釈を作成済みです。史料には家が倒れた町や火事が起こった場所が地名とともに書かれているため、地名ごとの被害状況を史料横断的に集約し、建物被害と火災被害の分布として江戸全体の被害状況を可視化したいと北本氏は述べており、この作業は現在進行中です。
もう一つの応用が加賀藩参勤交代データです。『御参勤・御帰国御道中日記』には、寛政8(1796)年4月6日から18日にかけて金沢を発って江戸へ向かった参勤の道程が記されています。道程を街道IDと対応づけると、R400北陸街道やR506北国脇往還を通ったことが分かります。これも進行中の作業です。
さらに長期的には、北本氏は地名識別子による地誌の検索を挙げ、地名項目データセットのIDとGeoLODのIDを論文中の地名に付与する例を示しました。識別子を埋め込めば同名地名を区別でき、外部情報源へのリンクも可能になるため、ある村について書かれた資料をまとめて取り出せます。ただし北本氏は、これはまだプロジェクトとして動いているものではなく、こうした使い方が考えられるという段階だと述べました。
ユースケースの共有と今後の課題
北本氏は、歴史ビッグデータの土台となるデータセットがだいぶ充実してきた現段階で重要になるのはユースケースの共有だと述べ、あわせてDiHuCoハブとしての今後の課題を四点挙げました。
データを利用するソフトウェア・アプリに加え、AIコーディングによる自作も敷居が下がってきました。どのような研究方法が成功し失敗したのかを共有し、それを参考にすることで、より多くの人がデータ/AI駆動型研究を活用できるようにしたいと北本氏は述べました。
国際的な相互運用性については、地理空間・地名・情報空間のいずれも国際的な活動との比較が必要です。データの継続的な更新では、大規模な歴史データに多くの誤りが混入するため、相互比較による修正が欠かせません。レスキューとキュレーションは、死蔵されたデータなどをよみがえらせて新たな価値を付加する取り組みです。持続可能性については、オープンデータの作成、サービスの運用、専門家の参加のいずれにも継続的な資金が必要だと述べました。
講演情報
- イベント:DiHuCoハブシンポジウム2026:Agentic DHに向けて~人文学×AIの多様化とAI協働型研究の広がり
- 講演日:2026-08-07
- 講演者:北本 朝展(ROIS-DS人文学オープンデータ共同利用センター/国立情報学研究所)
- 講演資料:人文学研究データリポジトリ(doi:10.20676/00000470)
- 講演動画:YouTube
関連リンク
- DiHuCo研究実践ハブの紹介〜Agentic Publishingによるガイドライン構築
- 北本 朝展 (Asanobu Kitamoto) - マイポータル - researchmap
- DHコンソーシアムプロジェクト(DiHuCo):研究実践ハブ/地図・地誌類領域
- 歴史的行政区域データセットβ版
- 『日本歴史地名大系』地名項目データセット
- 『日本歴史地名大系』施設・地点項目データセット
- 幕末期近世村領域データセット
- 藩IDデータセット
- 藩 一覧
- 藩代表点(居城・陣屋)データセット
- 石川藩
- 江戸主要街道データセット
- 江戸宿場データセット
- GeoLOD - 地名情報を集約する地名情報処理基盤
- 江戸マップ:江戸切絵図を活用した地名と地理のデータベース
- れきちず
- 蔦屋重三郎(蔦重)の足跡をたどる
- マップ(れきちず版)
- 歴史的ジオコーダー
- 旧東京市15区住所マップ
- GeoNLP - テキストを自動的に地図化する地名情報処理ソフトウェア
- 14 Names, Dates, People, and Places - The TEI Guidelines
- navPlace Extension
- 華北交通アーカイブ:よみがえる膨大な白黒写真
- メモリーグラフ(メモグラ) - 同一構図撮影を支援するカメラアプリ
- 「歴史ビッグデータ」プロジェクト
この記事は、講演記録を基に生成AIを利用して作成したユースケース記事です。