はじめに
北本朝展氏(ROIS-DS人文学オープンデータ共同利用センター/国立情報学研究所)による本講演は、歴史ビッグデータの作り方と使い方について、これまでに行ってきた作業の概要を紹介したものです。江戸切絵図の地名を現代の地図に重ねた江戸マップ、408の藩に識別子を与えた藩IDデータセット、街道や宿場のデータセット、参勤交代の道程を記述するデータ形式rokka(六何)/dochu(道中)などの事例を取り上げます。AIで効率化できる部分と、手作業でなければ難しい部分の両方が具体的に語られています。歴史資料から機械可読なデータを作りたい方や、地名・藩などの識別子の整備に関心のある方に役立つ内容です。
2018年の第6回CODHセミナーと歴史ビッグデータの対象
2018年3月12日、歴史ビッグデータをテーマにした初めてのセミナーとして、第6回CODHセミナー「歴史ビッグデータ〜過去の記録の統合解析に向けた古文書データ化の挑戦〜」を開催しました。様々な分野の研究者がデータ駆動型の歴史研究を紹介し、参加者はオンサイトのみで96名でした。
北本氏がこのセミナーで説明したことは2つあります。1つ目は出発点で、現代のビッグデータで普通に行われているデータ統合や時空間情報としての解析を、江戸時代のような過去についてもできないか、という問いです。2つ目は対象です。古気候の研究では、木の年輪の幅や氷河に含まれる二酸化炭素の濃度などの代替記録(プロキシ)という、書かれていないものを使って過去の気候を復元します。北本氏らはこれに対して、書かれたもの、あるいはそれをもとにしたものを対象とし、それによって現代と過去がつながっていることを、歴史ビッグデータの対象として説明しました。
8年間の取り組みとAIをめぐる状況の変化
2018年からの8年間、北本氏らは歴史ビッグデータの実現に向けて、データ基盤の構築と、ツールによる作業の効率化を進めてきました。北本氏は、そこでかなり後押しになっているのがAIだと述べました。2018年は深層学習が様々な分野に適用され始めた時期で、AIくずし字認識KuroNetの発表は2018年12月でした。2022年11月にはOpenAIのChatGPTが公開され、北本氏は、それ以来、生成AIが学術研究の方法論そのものを変えつつあると述べました。2026年8月のAgentic DHシンポジウムでは、研究の主体性はAIか人間か、デジタル化からAI化へ、という問いを立てています。
歴史ビッグデータの作り方と使い方
歴史資料から機械可読データを作る
歴史資料には、気候・地震・噴火・疫病などの自然科学的なデータや、経済・人口・政治・文化などの人文社会的なデータが書かれています。これらを資料から拾い、データ構造化のワークフローを通して機械可読データにするためのシステムが、歴史ビッグデータ研究基盤です。機械可読データになれば現代のビッグデータの技術で分析できるため、その作り方が課題になります。
歴史ビッグデータは、ネットのどこかにデータセットがあるわけではなく、作らないと使えません。資料はデジタル画像として公開されるようになりましたが、くずし字を読む必要があるなどのハードルがあり、画像があるだけでは、なかなかそのまま使えません。そのため北本氏は、機械可読・構造化データの構築をデジタルツールで支援する必要があるとしています。
すべてAIで作れるのではないかという話もありますが、北本氏は、AIを使える部分は多々あるものの、現実には「手作り」でないと無理な作業が多々あるとし、そのうえで、どこで苦労するのか、何を重視すべきか、AIはどこで役立つのかという問いが、このセミナーを貫く問いになるのではないかと述べました。
識別子と属性
北本氏が長く取り組んできたのが、識別子(ID)と属性の付与です。識別子の付与では、まとまりのあるもの(エンティティ)を列挙して番号や文字列を割り当て、同じIDを持つものは同じもの、違うIDを持つものは違うものとみなします。ただし北本氏は、何を同じとみなすかという判断基準は非常に難しい問題だと述べました。
属性について北本氏は、地名の場合は位置情報の付与が特に重要で、ほかにも名称の表記揺れや粒度の相違の吸収、名称の選択、よみの付与(漢字だけでは読みが分からないため)、基本統計の付与も必要だとしています。こうした識別子と属性の組をデータセット化し、実世界との紐づけとデータ統合に利用してきました。
江戸マップ:江戸切絵図の地名を現代の地図に重ねる
江戸マップは、29枚の古地図『江戸切絵図』から8788ヶ所の地名を抽出してデータベース化したプロジェクトです。現在は使われていない地名を拾っておくと、過去の資料に出てくる地名がどこにあったのかが分かり、実世界の中で理解できるようになります。
8つの作成手順
作成手順はカレントアウェアネスの記事にまとめられています(括弧内は作業の担当)。
- IIIF Curation Viewerで、地図に描かれた地名の画像座標と翻刻をキュレーション形式で収集する(AMANE)
- 立命館大学の矢野桂司氏が公開する「日本版Map Warper」で、切絵図と現代地図の間で対応する基準点(GCP)を設定し、ジオレファレンス(位置合わせ)する(北本氏)
- 得られた座標変換パラメータで、地名の画像座標から緯度経度を推定する(北本氏)
- 推定位置にマーカーを表示し、「れきちず」と現代地図の上で確認しながら、より正確な位置に移動させる(山本氏・北本氏)
- この作業を江戸切絵図1枚ずつ行い、全29枚の地名位置を修正する(山本氏・北本氏)
- すべての地名を1枚の地図に統合して表示し、複数の地図に登場する同一地名を統合する(北本氏)
- 統合作業で見つかった地名の誤りなどを修正する(AMANE)
- 「江戸マップ地名データセット」として公開し、GeoNLP地名語辞書形式に変換して地名情報処理基盤GeoLODに登録し、江戸マップ地名IDに加えて汎用的なGeoLOD IDを付与する(北本氏)
AMANEの担当分は、同社に依頼して行いました。北本氏は、手順が多く、それぞれに大きな手間がかかると述べました。
ジオレファレンスだけでは合わない理由
丸の内付近の切絵図は比較的よく合い、現代の通りが今も残っていることや、お堀が道路になったことが分かります。一方、巣鴨付近では、実際には遠い場所が近くに詰めて描かれています。北本氏は、その理由を、その場所も地図に入れたいからだと説明しました。周辺に行くほど観光名所を無理に描き入れているため距離も方位も歪んでいるものの、この道を行けばここにたどり着くというトポロジカルな関係としては正しいとし、江戸切絵図を、重要な地点を1枚に収めるために距離も方位も歪めた「トポロジカルな地図」と解釈すべきだと述べました。
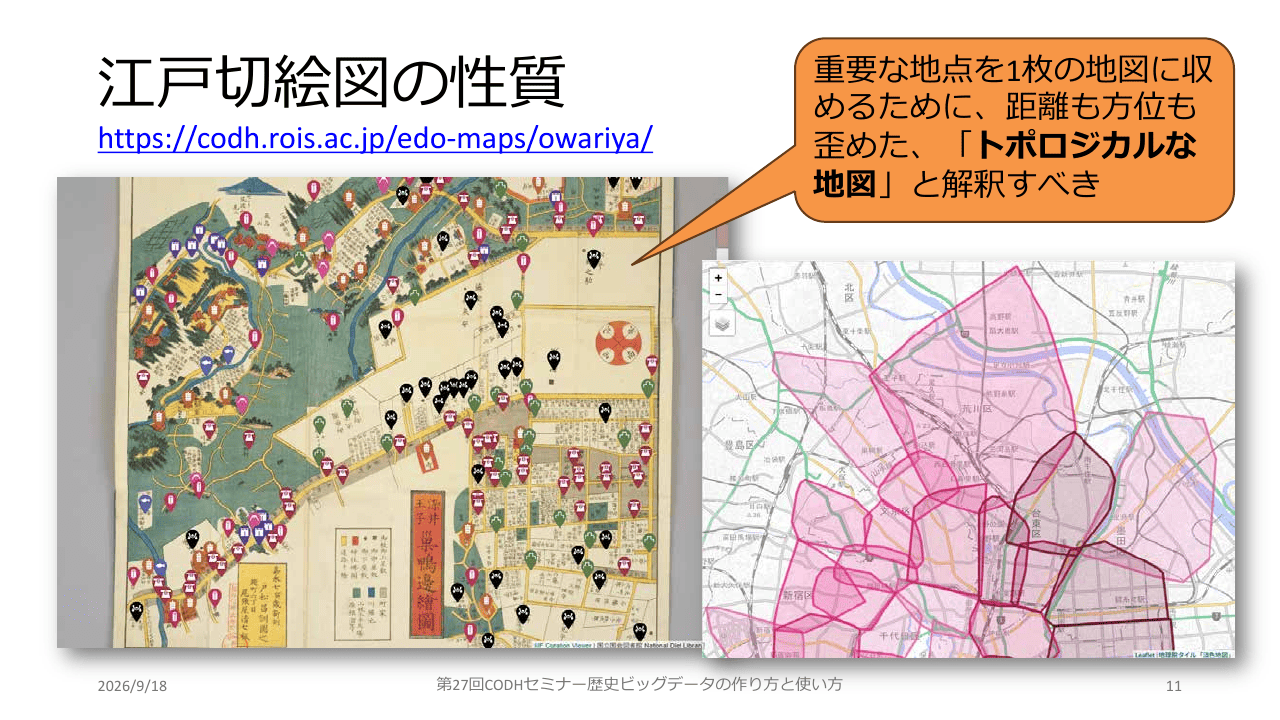
このため座標変換だけでは合わず、8788ヶ所のマーカーを1点ずつ動かしました。地図はGoogleマップなど複数を総合して使い、寺院についてはOpenStreetMapの方が使いやすいことが分かりました。
江戸マップの全体像とれきちず
地名を一覧すると、江戸城を取り巻く町人の地域(赤)と武士の地域(黒や緑)がある程度明確に分かれていることや、寺院(オレンジ)が比較的江戸の周辺を取り巻くように分布していることが分かります。海岸線は現在の東京とは大きく異なり、当時は島だった場所が今は地名としてだけ残っている例もあります。
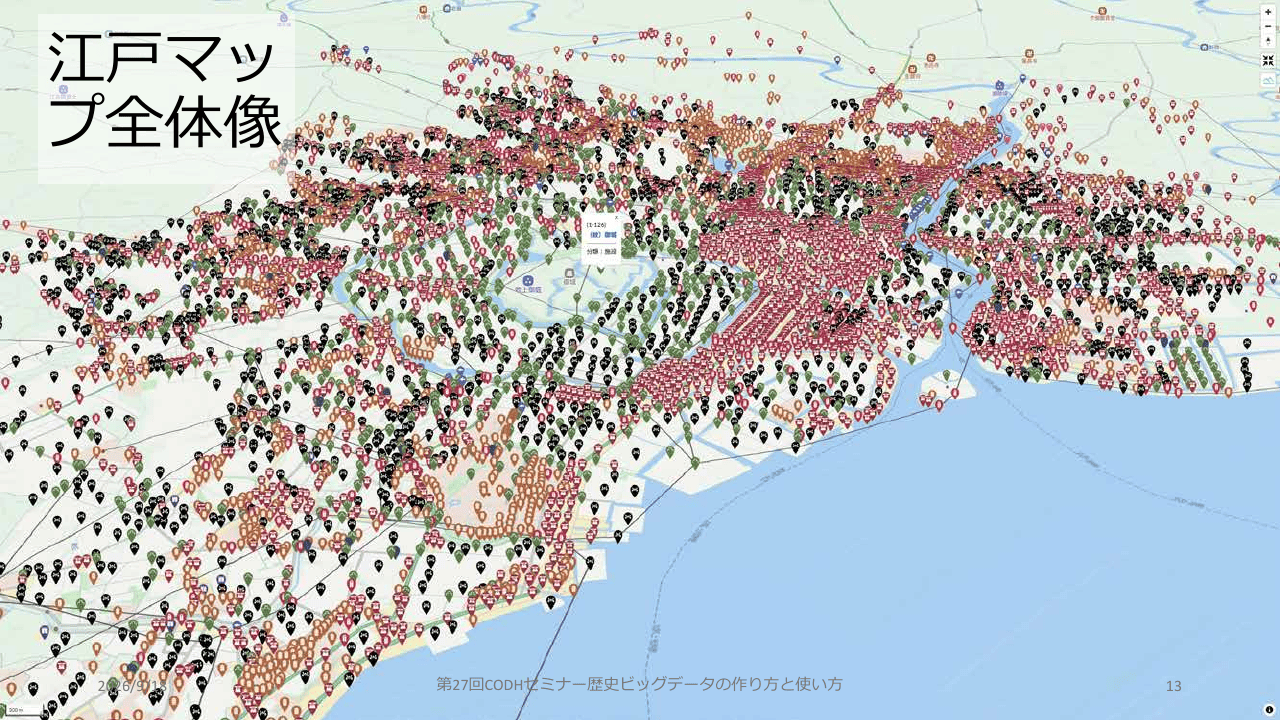
こうした情報は江戸時代の地図に重ねると理解しやすいため、「れきちず」に重ねています。れきちずは株式会社MIERUNEが運営する現代風デザインのWeb歴史マップです(CC BY-NC-ND)。れきちずについては、このセミナーの後の講演で加藤氏が紹介しています。
地名・街道・宿場のデータセット
歴史地図を作るには、地名以外にも様々なデータセットが必要です。北本氏らは、次のようなデータセットを構築・公開してきました。
- 『日本歴史地名大系』地名項目データセット:平凡社の非常に分厚い地名辞典の地名項目に位置情報を加えて機械可読データ化し、江戸時代の村までさかのぼる80,502件をCC BYライセンスで公開しました。項目のIDと名前などはオープンにし、辞書独自の内容はクローズとする、出版社と協力したオープン・クローズ戦略をとっています
- 江戸主要街道データセット:五街道および主要脇街道の道路データで、総延長は約8360kmです。街道IDは、五街道だけ一桁、その他は地域ごとに三桁の番号を付与しています。文献によって街道の名称が異なってもIDで管理すれば同じになるので、移動のデータを扱うときに便利です。MIERUNEとの共同作業です
- 江戸宿場データセット:『日本歴史地名大系』の宿場の記述を街道IDごとにリスト化し、宿場IDを付与しました。東海道の品川宿はR001-002となります。平凡社地図出版との共同作業です
このほか海岸線や湖沼のデータも作成・公開しており、これらを統合していくことで、過去の地図がだんだんと充実してきます。
藩IDデータセット:何を同じ藩とみなし、何と呼ぶか
藩がいくつあったのかは、一つに決められません。藩IDデータセットでは、江戸・明治時代の藩として408藩に識別子(ID)を付与し、藩名と別名も定義して、点や領域の地理情報とリンクしました。武鑑全集の整理にも活用しています。江戸時代の関係は大名家→藩なので、藩を先に定義するのは逆転ではないかという話もありますが、北本氏は、大名家と藩は一対一ではないため両方のIDが必要だと説明しました。
同一性の判定基準と代表的な名前
江戸期から明治期の藩には、政権による公式のリストが存在しません。藩の定義は歴史研究そのものなので扱わず、『藩史大事典』(新装版1巻〜8巻, 2015)、『角川新版日本史辞典』(1996)、『岩波日本史辞典』(1999)などを比較して、統合や分離を検討しました。対象は寛文4年(1664)から明治4年(1871)に存在した藩です。
藩の名前にも公式の定義がなく、薩摩藩か鹿児島藩かのように、文献によって表記が異なります。地名(居城地)を使うか家名を使うか(仙台藩か伊達藩か)という問題があり、戦国時代から続く由緒ある大名家は家名で呼ばれることが多くあります。同名藩もあり、松山藩は、松山(出羽)、松山(伊予)、松山(備中)の3つです。現代の利用実態としてJ-STAGEの論文数やWikipediaの用例も参照し、北本氏は、よく使われている名前を代表名に選んだ方がよいと考えたと述べました。例えば薩摩を代表藩名とし、鹿児島と島津を別名としています。
識別子によるデータ統合の利点
別名をまとめておくと、藩ごとの研究の多さも調べられます。J-STAGEで別名をORでつなげて論文数を検索し(例:「仙台藩 OR 伊達藩」)、同名藩は「名称 AND 国名」の検索数を用いて全体の件数を比例配分しました。最大の薩摩藩を100として正規化した注目スコアでは、薩摩(100)、加賀(93)、長州(73)、仙台(71)の順になりました。
藩の領分と代表点
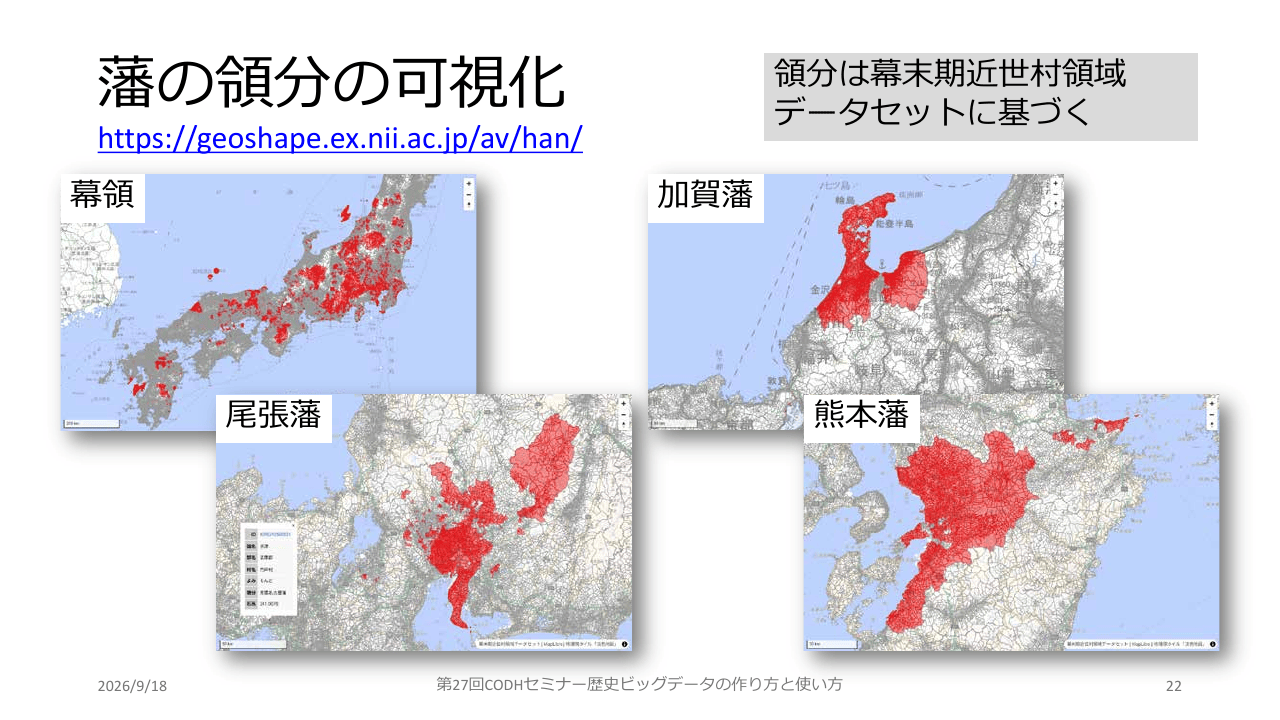
後の講演で本田氏が紹介する幕末期近世村領域データセットに基づいて藩の領分を可視化すると、熊本藩や尾張藩などの領分が結構分かれていて、あまり一塊というイメージではないことがよく分かります。また、藩を一点で代表させる藩代表点(居城・陣屋)データセットも作り、『日本歴史地名大系』ともリンクしました。小さい藩にはどこに陣屋があったのか分からないものもありましたが、408藩の代表点を一応決めました。
参勤交代の復元とrokka/dochu
全国の参勤交代と加賀藩の道程
藩の代表点が決まると、参勤交代の動きを可視化できます。武鑑から何月に何藩が移動したのかが分かるため、全国の藩の動きをアニメーションで表示しました。寛政武鑑(1789)を用いた画面では、寅年の12月に参府が13藩、暇が0藩、江戸にいる藩が160藩と示されています。
加賀藩の参勤交代は特に人数が多く、数千人いたのではないかとも言われています。日記(『御参勤・御帰国御道中日記』)をたどると、何月何日にどこへ移動し、どこに泊まったのかが分かります。加賀藩の参勤交代(参府1796/暇1797)のうち、前田治脩の参勤(金沢→江戸)を、街道データや日記の解読などを組み合わせて地図上のアニメーションにすると、軽井沢付近から碓氷峠を下り江戸へ向かう様子が分かります。
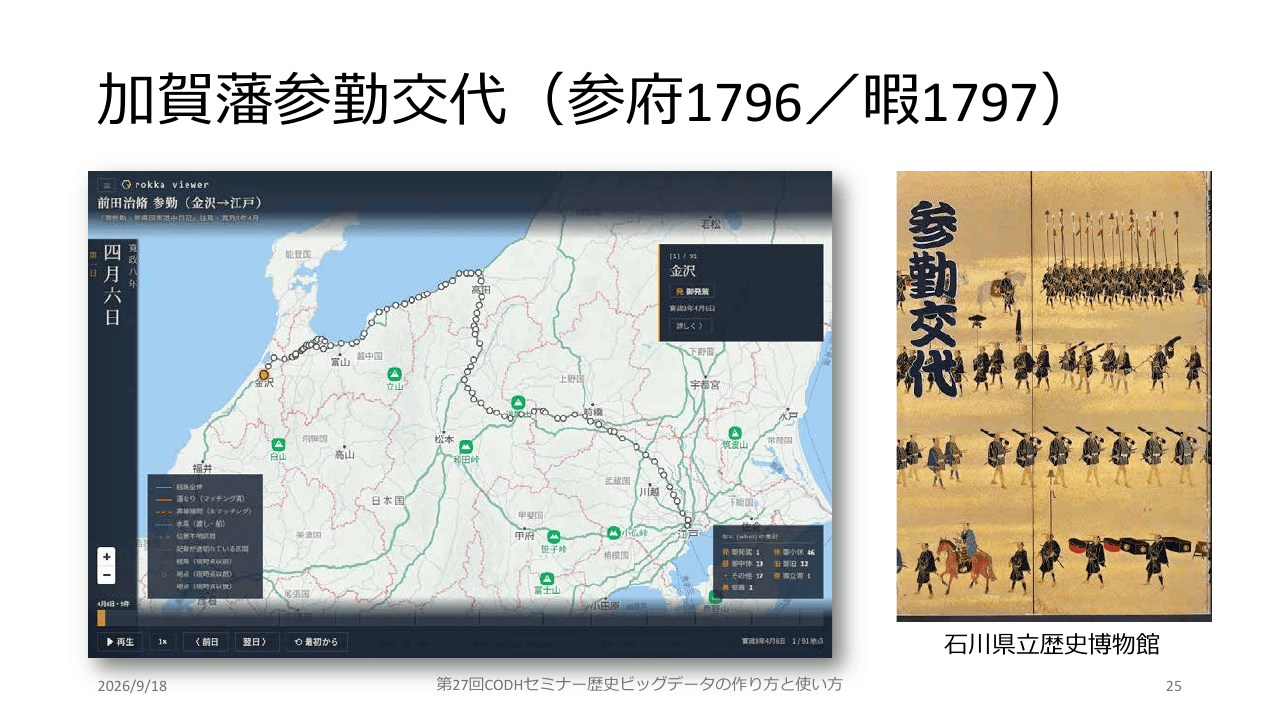
親不知を越えるまで
北本氏が特に面白いところとして紹介したのが、山が海に迫り、波打ち際を歩かないと越えられない難所の親不知です。日記によると、波が高く下の道は通れず、山へ回れば差し支えはないものの、駒返の通行には差し支えがあると、境奉行から飛脚で知らせがありました。その後、道中奉行らが駒返まで出向いて見分すると、次第に波も治まって差し支えがなくなり、一行は親不知では山へ回り、駒返と姫川も滞りなく越えて、暮れ時前に糸魚川に着いています。北本氏は、なぜそこを通らなかったのか、なぜそこを通ったのかが全部書かれているとし、通れなければ先の予定がすべて狂う巨大な行列なので、何としてでも通らなければならず、頑張って通ったことが分かると述べました。
rokka(六何)とdochu(道中)
こうしたデータを記述するために開発しているのが、rokka(六何)/dochu(道中)です。rokkaは資料中の事象の記録を、だれ・いつ・どこ・なに・なぜ・どうやっての5W1Hで記述する形式、dochuは資料中の移動の記録を記述する形式で、rokka viewerは両形式に対応しています。親不知の例では、なに=御発駕、なぜ=資料の記述(波が高く下の道は通れない)、どうやって=駕籠のように要素に分け、「いつ」はHuTimeで和暦を西暦に変換、「どこ」には街道IDや宿場ID、GeoLOD IDなどを対応づけます。移動の拡張を足すとdochuになります。
安政江戸地震と生成AIによる道程の抽出
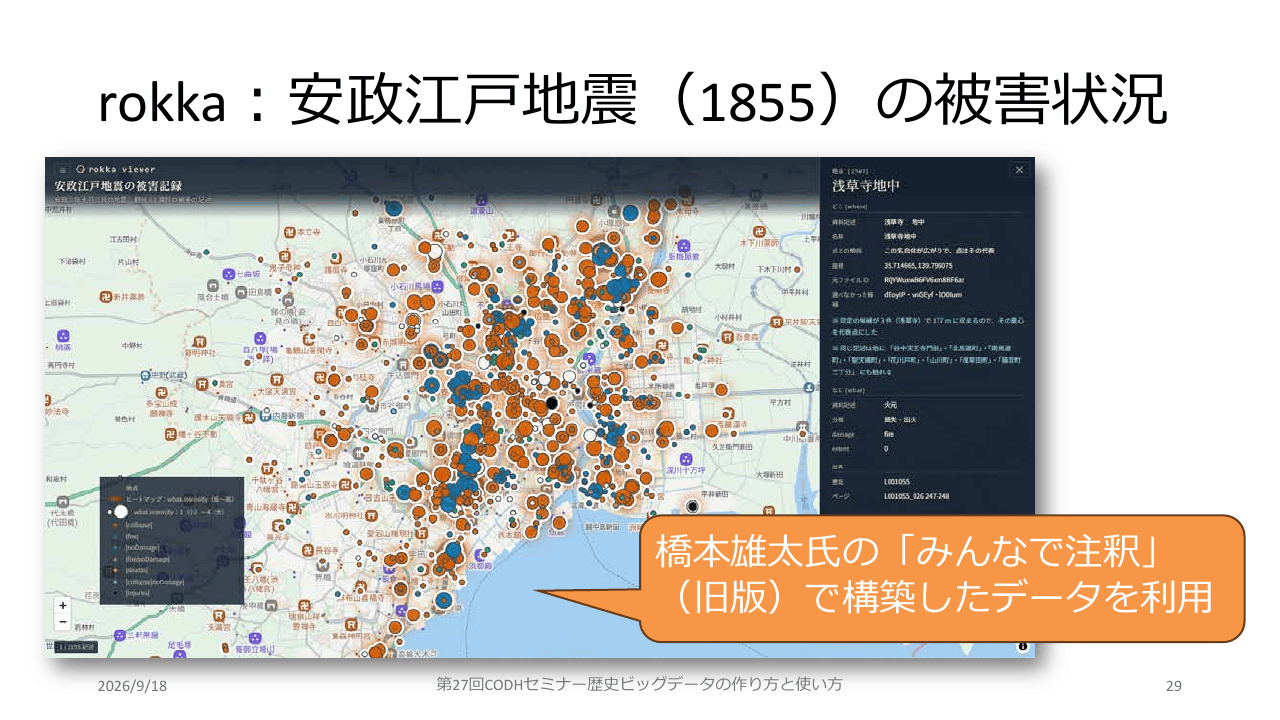
rokka形式の例として、安政江戸地震(1855)の被害状況があります。これは、橋本雄太氏の「みんなで注釈」(旧版)で構築したデータを可視化したものです。北本氏は、資料を丹念に紐解いていくことで、どのあたりで火災の被害や家屋の倒壊があったのかをこのように可視化できると述べました。
AIでデータを作れないかという試みも行っています。清河八郎の旅の日記『西遊草』(岩波書店, 1993)の巻の十のうち数日分をClaude Opus 5に入れ、dochu形式で抽出するようプロンプトで指示すると、何日にどこにいて、歌舞伎を見に行った、誰かと会ったといった情報を一応抽出できました。その結果をrokka viewerに入れると、何日にどこへ動いたのかが分かります。
歴史ビッグデータの夢と、品質・協働の課題
似たプロジェクトは世界中にあります。Time Machine Europeは欧州の歴史をデータ化し、タイムマシンのように様々な時代に移動できるようにするプロジェクトで、北本氏も以前に記事を書いています。最近はThe AI HistorianのようにAIで歴史を分析するプロジェクトも提案されています。
品質への挑戦
北本氏は、品質について次の点を挙げました。
- 過去の記録には曖昧さがあり、現代のようにコード化・標準化・数値化されていない
- 過去の記録には不可視性があり、存在しない記録を補う際には慎重な判断が必要である
- 曖昧さや不可視性は、複数データの突合や比較によって解消できることもある
- 識別子の維持管理や、専門知識・世界知識の検索・利用を効率化する研究基盤が必要である
協働への挑戦
北本氏は、歴史ビッグデータは巨大で一人でできるとは思えないため、多人数で協働できることが望ましいと述べました。形式を厳密に定めずに機械可読データを作っていく、やわらかいデータ構造化に関しては、「みんなで翻刻」がこの分野の画期的な成功例だとしました。みんなで翻刻は、橋本氏、加納靖之氏、大邑氏らのプロジェクトです。一方、北本氏は、非常に厳密に構造化していく、かたいデータ構造化では、IDの統一と更新対応、語彙の統一、形式の変換などで作業者の負担が増えるとし、みんなで翻刻は緩くやったおかげでうまくいった面があると述べました。作業の同期についても、完全に分離したワークフローの成果を最後に合わせるのはかなり困難だとしました。
今後の展望とまとめ
北本氏は、今後取り組みたいこととして、「デジタル江戸:歴史ビッグデータのための意味空間の構築とデータ駆動型実験の展開」と題し、様々な構造化データを統合解析できる実験環境の構築、参勤交代や旅行ルートなど人々の動きの構造化と動的な現象のシミュレーション、言語モデル(埋め込み空間)によるデータ間の関連性の統計的な計算、知識グラフによる概念間の関連性の明示的な定義を挙げました。
また、講演の記事をAIで生成して蓄積・活用するDiHuCoガイドラインシステム(DGS)を紹介し、この講演の記事もDGSで公開する予定だと述べました。
まとめとして北本氏は、識別子を付与したデータセットと、データ構造化のためのデジタルツールを構築することが重要だと述べました。AIによって効率化できる余地は大きいものの、手作業でないと困難な部分がまだ多々あり、巨大な歴史ビッグデータの共同構築への期待は高い一方で、品質や協働の面で多くの課題が残っていると指摘しています。
講演情報
- イベント:第27回CODHセミナー - 歴史ビッグデータの作り方と使い方~ データを手作りするプロセスとデジタルツール~
- 講演日:2026-09-18
- 講演者:北本 朝展(ROIS-DS人文学オープンデータ共同利用センター/国立情報学研究所)
- 講演資料:doi:10.20676/00000480
- 講演動画:YouTube
関連リンク
- 北本 朝展 (Asanobu Kitamoto) - マイポータル - researchmap
- 「歴史ビッグデータ」プロジェクト | ROIS-DS人文学オープンデータ共同利用センター
- 江戸マップ:江戸切絵図を活用した地名と地理のデータベース | ROIS-DS人文学オープンデータ共同利用センター(CODH)
- E2818 – 江戸マップ:江戸切絵図を活用した地名と地理のデータベース | カレントアウェアネス・ポータル
- 江戸切絵図 尾張屋版 | 江戸マップ
- れきちず | 江戸時代の歴史地図を現代風デザインで
- 蔦屋重三郎(蔦重)の足跡をたどる - 特集 | edomi - 江戸をみる/みせるデータポータル
- 『日本歴史地名大系』地名項目データセット | Geoshapeリポジトリ
- 江戸主要街道データセット | ROIS-DS人文学オープンデータ共同利用センター(CODH)
- 江戸宿場データセット | ROIS-DS人文学オープンデータ共同利用センター(CODH)
- 藩IDデータセット | ROIS-DS人文学オープンデータ共同利用センター(CODH)
- 藩 一覧 | 幕末期近世村領域データセット
- 藩代表点(居城・陣屋)データセット | ROIS-DS人文学オープンデータ共同利用センター(CODH)
- 参勤交代 アニメーション - {101} 寛政武鑑 (寛政1/1789) [200018823] | 武鑑全集
- rokka(六何) / dochu(道中) - 事象記録を5W1Hに構造化するデータ形式 | ROIS-DS人文学オープンデータ共同利用センター(CODH)
- Time Machine Organisation
- 「過去のビッグデータ」を探る欧州タイムマシン研究計画
- The AI Historian
- DiHuCo Guideline System
この記事は、講演記録を基に生成AIを利用して作成したユースケース記事です。