はじめに
17世紀の日本で使われた古活字は、およそ50年のあいだ使われたのち姿を消し、実物がほとんど残っていません。ROIS-DS人文学オープンデータ共同利用センター(CODH)/国立情報学研究所の北本朝展氏は、嵯峨本『徒然草』のデジタル画像から活字ブロックを自動的に切り出し、同じ活字による刷りをまとめて物理的な活字を同定する研究を進めています。あわせて、その成果を用いて現代日本語をくずし字画像に変換するそあん(soan)を公開し、古活字を研究の外へ開く試みにも取り組んでいます。これらの作業をAIエージェントとの協働で進めた経験は、Agentic DHという枠組みとともに語られました。カラーヌワット・タリン氏(Sakana AI)、本間淳氏(FLX Style)との共同研究です。古典籍のデジタル分析や、研究成果を一般に開く方法に関心のある方に役立ちます。
Agentic DHという視点
北本氏は、デジタル化を前提としてきたデジタルヒューマニティーズ(DH)がいま、AIにどこまでエージェンシーを委ねるかという新しい軸に直面していると述べ、この状況をAgentic DHと呼んでいます。
その背景として北本氏は、多くの数学者が挑んできたヤコビアン予想が解かれ、その発見にAnthropicのClaude Fable 5が使われたとみられる事例や、数学者のブログを挙げました。このブログは、自分の名前が定理や定義に永く結びつく喜びを味わえる時代は終わりに近いかもしれないと述べ、大規模言語モデル(LLM)が比較的やさしい問題を解ける段階にあるなら、研究を始めたばかりの博士課程の学生に取り組みやすい問題を与えるという指導の常道は選べなくなるとも指摘しています。
北本氏は、人とAIの関わり方を3段階に整理しました。一つ一つの作業を指示して確認するhuman-in-the-loopはマイクロマネジメント、方向を示して委ね結果を確認するhuman-on-the-loopは権限移譲、出てきた結果をそのまま使うhuman-out-of-the-loopは丸投げにあたります。この並びを踏まえ、将来の研究者はAIの指揮者になると北本氏は考えています。指揮者が楽器を調整して良い音楽を作る責任を負うように、研究者も多くの作業をAIに委ねながら、研究を成功させる責任は手放しません。
エージェンシーは、人が行為者としてどう行動し決定するか、どれだけ自律的かを問う概念として、人文学・社会科学で長く研究されてきました。AI業界では、個人の資質としてのエージェンシーの希少性が論じられ、知能よりもエージェンシーが重視されると語られています。北本氏は、いま起きているのは知的活動におけるエージェンシーの変化ではないかと問いかけ、これを2つの軸で整理します。アナログとデジタルの軸は、計算可能性とアクセシビリティを高める一方向の変化です。これに対して人間とAIの軸は、エージェンシーの配分を選ぶ変化です。Agentic DHに至るにはデジタル化からAI化への転回が必要ですが、デジタル化をやめるわけではありません。デジタル環境から出発した人々、とりわけ若い世代は、この転回そのものを必要としません。デジタル化を経ずにAI志向の新しい研究が実現することも考えられます。
古活字が投げかける問い
古活字は失われた技術であり、刷られた本の画像からしか実態に迫れないという制約が、この研究の出発点になっています。
活字印刷の技術はヨーロッパから朝鮮半島を経て日本に伝わりましたが、日本の文字体系はヨーロッパのそれとは異なり、一つのブロックに複数の文字が彫られることがあります。研究の対象としたのは嵯峨本『徒然草』で、国会図書館本、内閣文庫第一種本、内閣文庫第四種本を用いています。
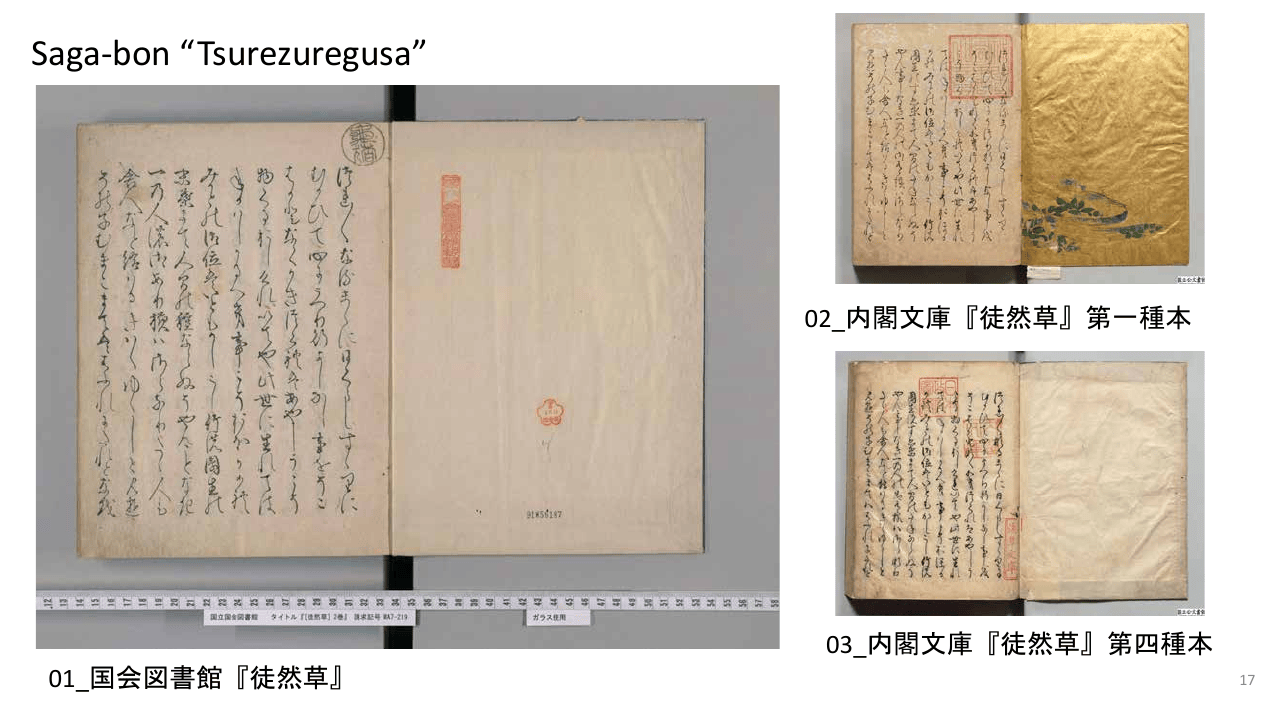
古活字が広く使われた期間はおよそ50年にとどまり、物理的な古活字はほとんど残っていません。デジタル画像を見ても古活字の境界は見えないため、組版の過程を復元できません。そこで北本氏は、古活字の分割と同定のためのアルゴリズムが必要であり、それが実現すれば網羅的な定量分析によって出版史の謎に迫れると位置づけました。
活字ブロックの自動分割
版面の画像から活字ブロックの境界を推定する処理は、2つの前提のうえに組み立てられ、AIエージェントによるコード開発によって精度が大きく高まりました。
前提は2つあります。ブロックの高さが正規化されており、文字1つ分の高さである1ユニットの整数倍になること、そしてブロックのあいだに空きのないベタ組みであることです。この2つは対象とする資料でおおむね成り立ちます。
カラーヌワット・タリン氏が開発したAIくずし字認識アプリみを(miwo)そのものではなく、その背後で動くAIくずし字認識モデルRURIを利用します。処理は3段階で進みます。第1段階では、AIくずし字認識モデルRURIで文字の矩形を認識し、その矩形からデジタル化の際に生じた1〜2度の傾きを推定して補正します。第2段階では、行を検出してグリッドを推定し、版面にグリッドを重ねます。第3段階では、筆線とグリッドの交差を確認します。筆線がグリッドを横切っていればそこでは分割できず、同じブロックと判定します。交差がなければ、そのブロックは分割できる可能性があります。
タリン氏は、2023年の時点では、この処理を行うコードを自分で考えて手入力していました。分割の正確さを示すF1スコアは0.8599で、結果としては良いものの、筆線を切ってしまう誤りや、空白の部分を切ってしまう誤りが残りました。
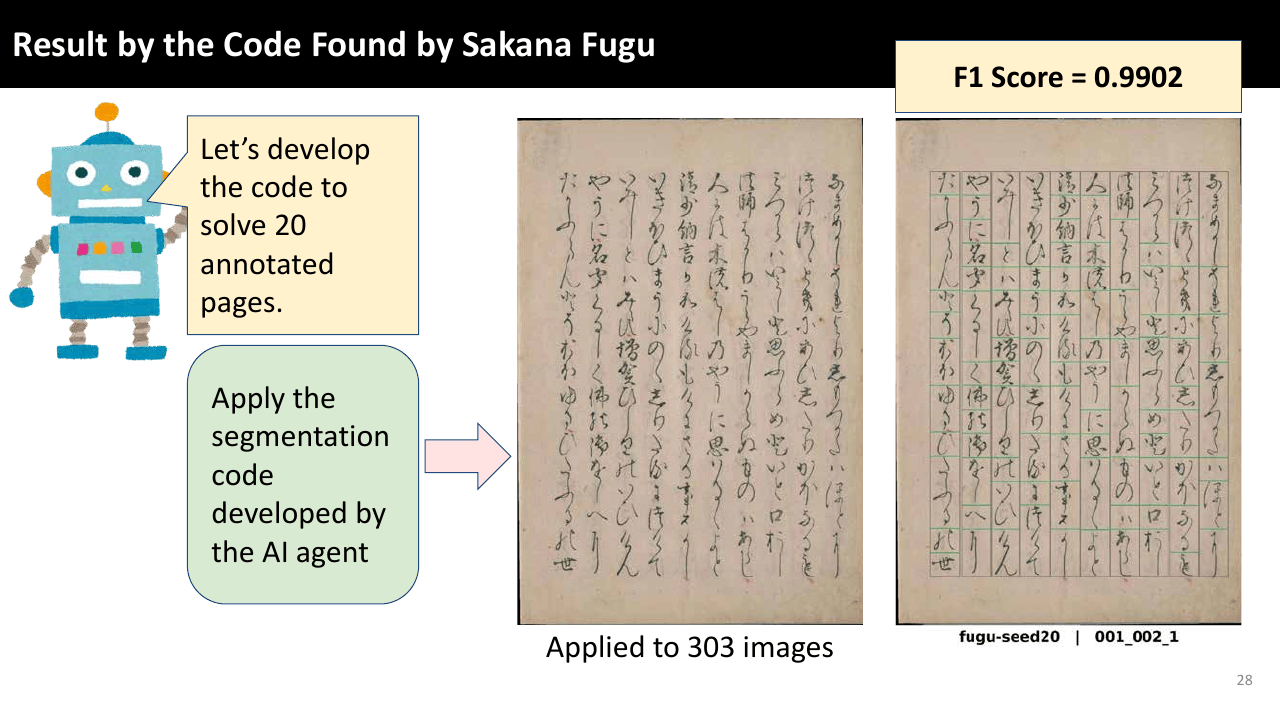
その後、ソフトウェアの書き方そのものが変わりました。2026年6月に公開されたSakana Fuguは、複数のLLMやAIを組み合わせ、オーケストレーターがそれらを制御して結果をまとめるマルチエージェントシステムです。タリン氏はこのシステムに、分割処理の仕様と、人手で注釈した20ページの正解データを与えました。AIがコードを書き、20ページで結果を確認し、誤りをフィードバックするエージェンティックループを回すことで、AIがコードを改良していきます。こうしてできたコードを残りの303画像に適用したところ、F1スコアは0.9902に達しました。良い仕様と良い事例を与えれば、AIが自らコードを開発できる段階に来ており、AIとの関係が変わりつつあると北本氏は述べました。
古活字データセットV2
分割の成果は古活字データセットとして公開します。V1の人手開発のコードの代わりに、V2ではAI開発のコードを用いています。
V2の総ブロック数は37,314です。1つのブロックに含まれる文字数の内訳は、1文字が61.00%、2文字が28.60%、3文字が8.90%で、4文字以上のブロックは少なく、最大は7文字です。連綿する文字が1本の活字に彫られるため、このような長いブロックが生じます。
ブロックの高さを表すユニット数と、そこに彫られた文字数の関係も集計されています。両者が一致するものが93.5%、ユニット数が少ないものが3.6%、多いものが2.9%です。この差が生じる理由は、組版の分析から説明できます。
活字ブロックの同定
刷られた版面から物理的な活字へさかのぼるために、同じ文字の刷り同士を比較して同一の活字にまとめる処理を設計しました。
古活字データセットが捉えているのは印刷の出力です。次に知りたいのは入力、すなわち物理的な活字であり、再利用された活字は複数回数えられるため、真の本数と、どの活字がどれだけ使われたかという利用のパターンが問題になります。
同じ文字の2つの刷りは、文字としては常に似ており、手がかりになるのはインクが一致しない部分の形です。同一の活字による刷りでは、インキングや圧力、紙によって輪郭に沿った細い縁だけが違います。別の活字であれば、筆画そのものの位置が違います。手で彫られたものなので、2本として同じ彫りはありません。
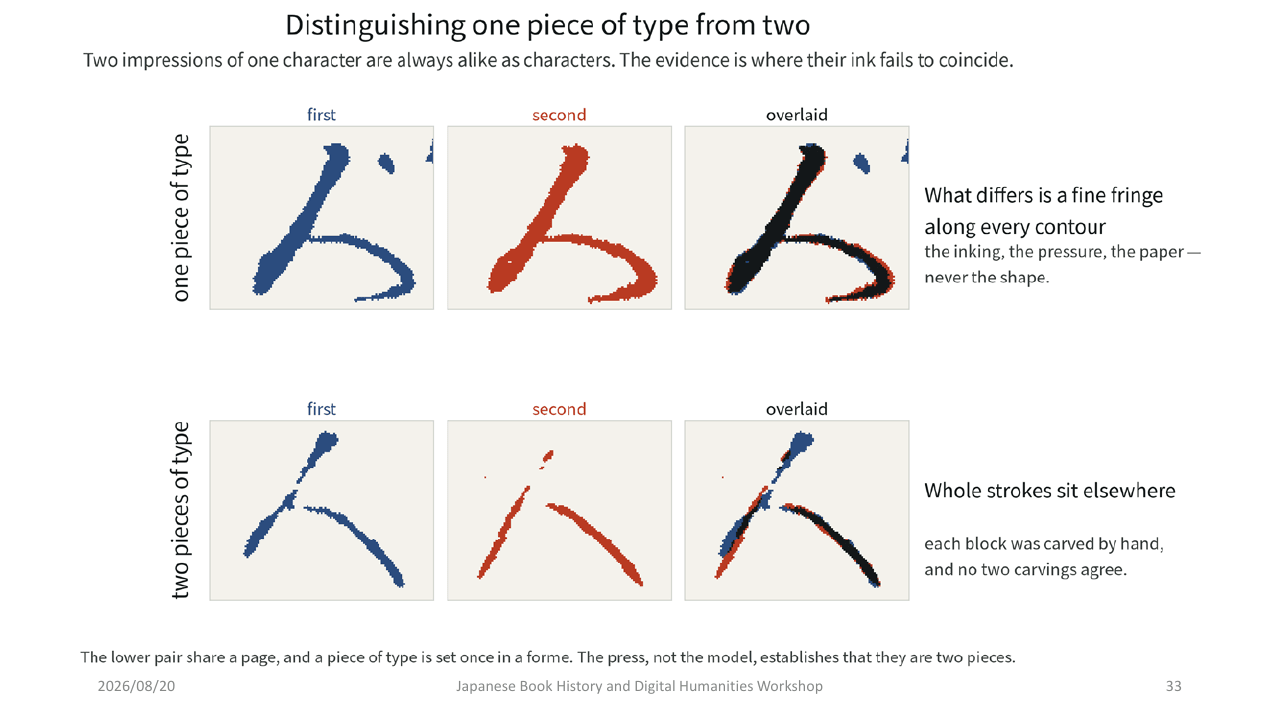
比較には2つの測度を使います。ssim_inkは筆線が一致するかを、diff_blobsは余ったインクがどのような形をしているかを測ります。併合の順序を決めるには一つの尺度が必要なので、この2つをロジスティック回帰で1つの数値にまとめます。式はP = σ(5.17·z1 + 0.88·z2 − 0.57)、z1 = (ssim_ink − 0.40) / 0.36、z2 = (diff_blobs − 53) / 46 であり、σはロジスティック関数で、合計値を0〜1の範囲に写します。2つの重みは注釈済みのペアで学習しています。
続いて、制約付き平均連結の凝集型クラスタリングを行います。それぞれの刷りを1つの族として始め、平均類似度が最も高い2つの族を併合する操作を、0.85を超える組み合わせがなくなるまで繰り返します。判定に使うのは最も高い値ではなく組み合わせ全体の平均です。「手」の字では、37の刷りが4本の活字にまとまりました。
結果の検証には、刷られた紙そのものを独立した手がかりとして使いました。クラスタリングにはページ(半丁)の情報を与える一方、丁の情報はどの段階でも与えていません。1枚の紙(丁)は1つの版から一度に刷られ、1本の活字はそこに一度しか置かれません。集計すると、同じ見開きで向かい合うページでは11,411ペア中227件が同じ活字にまとまったのに対し、同一丁では11,034ペア中1件にとどまりました。見開きの割合から考えれば同一丁でも約220件起きるはずであり、この差はクラスタリングが丁の構造と整合していることを示します。
同定の暫定的な結果は、セグメント37,314、クラスタ(物理的なブロック)8,494、最大のクラスタサイズ40、シングルトン3,467(40.8%)です。ただしシングルトンは多く見積もられている可能性があり、実際にはより少ないと北本氏は見ています。結果は古活字ブロック分析として公開しており、改良は現在も続いています。
活字面の復元と組版の復元
同定した活字ごとに刷りを平均すると活字の面が浮かび上がり、1行17ユニットという枠のなかで組版がどう工夫されたかも見えてきます。
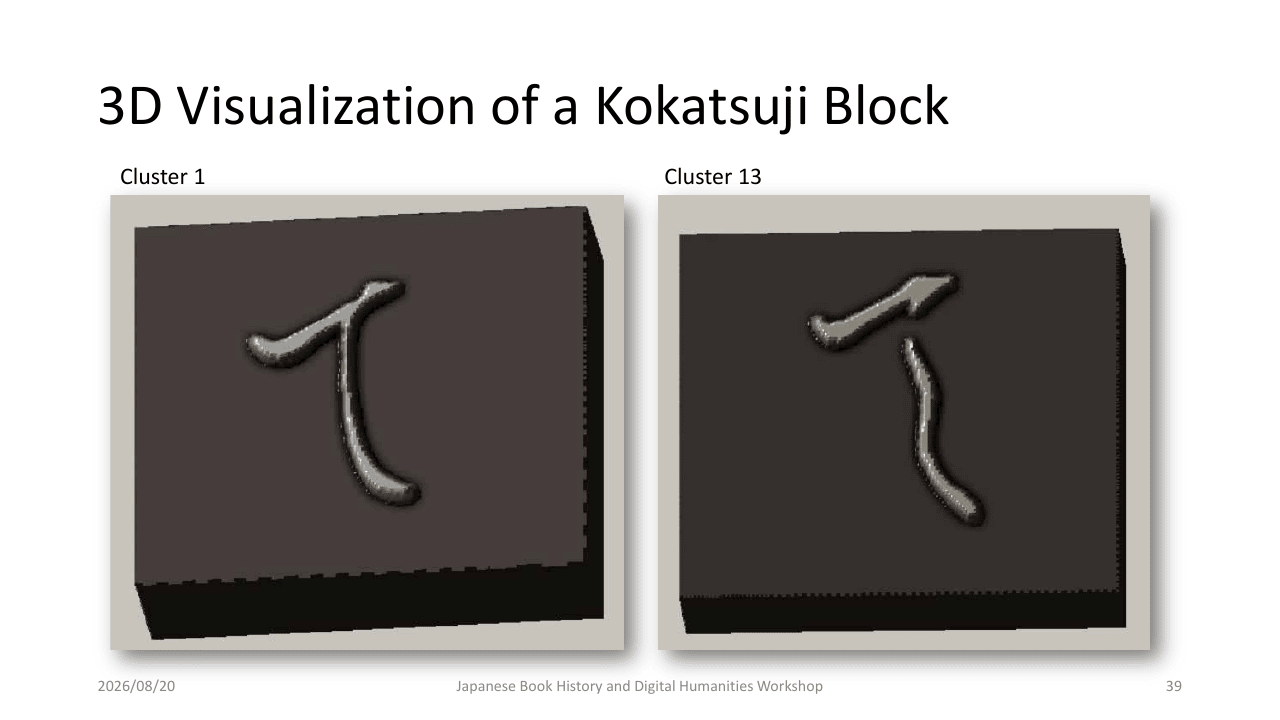
インキングと圧力は刷るたびに変わりますが、ブロックそのものは変わりません。ある活字の40の刷りには、濃く刷られたもの、かすれたもの、にじんだものが混じっていますが、位置を合わせて平均すると変動する要素が消え、活字の面が復元されます。最も濃い領域は、40の刷りすべてにインクが乗っていた部分です。この本からは1,601の印刷面を復元しました。復元した活字の面は3次元的な立体としても可視化でき、インクの濃淡が凹凸として表現されます。周辺の部分が刷られたり刷られなかったりするのは、圧力やインク、ブロックの汚れなどによるものとみられます。
組版の側では、1行の高さが17ユニットに固定され、短い行を詰め物で埋めることはしません。変わるのはテキストの側であり、同じ文字が複数の異なるボディに載ります。ふだんより背の高い活字に載せれば1ユニットを稼ぎ、連綿の活字を使えば1ユニットを節約できます。全書で見ると、88.3%の行が17ユニットちょうどに収まり、これを超える行はありません。仮にすべての活字がふだんのボディだとすると、ユニットが不足する場合の方が多く、したがって背の高い活字の方がよく使われる道具になります。
この組版の分析は、講演の前日に羽田発JFK行きの機内で得られたものです。北本氏はWi-Fiに接続し、AIコーディングエージェントのClaude Codeと議論しながらソフトウェアを開発して仮説を検証しました。
そあん(soan)による古活字の再生
分析で得た古活字の画像を使い、現代日本語のテキストをくずし字の版面に組む仕組みを公開したところ、創作や学習の場で使われるようになりました。
そあん(soan)は、古活字データセットの古活字画像を用いて、現代日本語テキストをくずし字画像に変換し、共有するサービスです。本間淳氏との共同開発です。そあんライブラリは2段階で処理します。第1段階では、形態素解析でテキストをトークンの列に分割し、そのトークンをもとに候補となる古活字画像の組み合わせを作ります。組版では語の境界で改行するため、トークンの情報が必要になります。第2段階では、1行の文字数と行間からレイアウトを作り、組版ルールで選択を確定します。嵯峨本の時代の組版ルールはわからないため、ここで使うのは主に現代の組版に由来する制約と調整です。
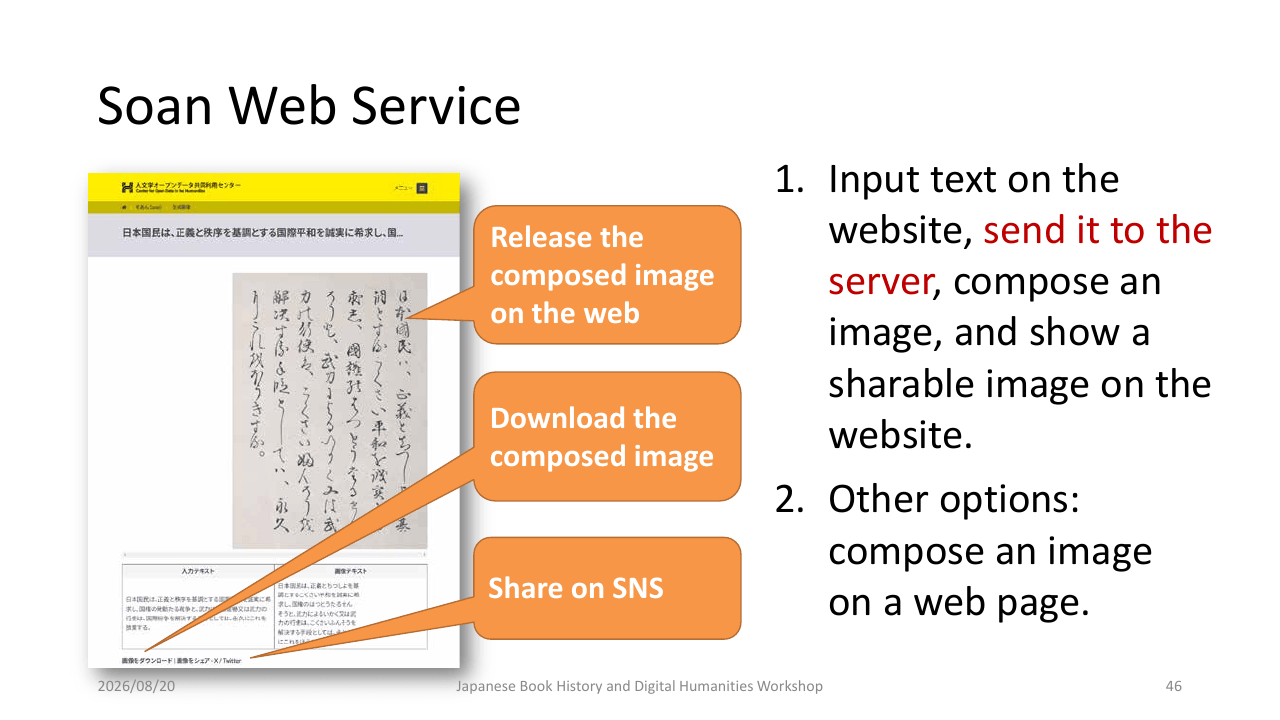
ウェブサービスでは、テキストを入力するとサーバで画像を合成し、公開・ダウンロード・SNS共有ができます。アカウントを友だちに追加してテキストを送ると画像が返ってくるLINE版も用意されています。公開後は、くずし字を使いたくても書けない人たち、たとえば古典を題材にした作品を作る人たちに使われています。
くずし字の学習にも応用できます。従来の学習では文字と内容の両方を理解する必要があり、内容の理解には文法や語彙、背景知識が求められます。内容に関心を持てなければ、その障壁を越える動機が続きません。そあんを使う学習では好きなテキストから学べるため、文法や語彙、背景知識をすでに持った状態で、文字だけに集中できます。山形大学の生田慶穂氏は、そあんで組んだ教材を1年生の授業で使いました。漫画などから採った有名な台詞を使って学生の関心を引いたところ、学生からはもっとくだらないテキストを読みたいという反応が返ってきました。
北本氏は、この取り組みを復元(reconstruct)と再生(revive)の区別で説明しました。復元は、対象を研究するためにできるだけ忠実に過去の本を作り直すことです。再生は、現代の人が使える形で過去の本の遺産を作り直すことです。そあんが目指しているのは再生であり、だからこそ嵯峨本にない文字、たとえば英語のアルファベットを追加しました。古いコンテンツを新しいプラットフォームに載せるというこの考え方は、江戸料理レシピデータセットにも共通しています。
知見と展望
分割と同定はAIとの協働で大きく前進しましたが、まだ課題も残っています。
古活字の分割はエージェンティックループによって解決しましたが、他の本への一般化は今後の課題として残っています。本ごとに条件が異なるため、それらを扱う方法が必要になります。古活字の同定はAIによるエージェンティックコーディングで解決したものの、性能の改善は現在も進めており、最終的な結果には至っていません。
古いコンテンツを新しいプラットフォームに載せて文化遺産を再生することは、パブリック・ヒューマニティーズの新しいアプローチになると北本氏は位置づけています。そしてAgentic DHは、研究のやり方と成果の公開のやり方を変えるとともに、知性についての私たちの信念への挑戦になります。かつて人間は最も知的な存在の一つでしたが、その状況は変わりつつあります。これにどう向き合うかが、研究の新しい可能性につながると北本氏は述べました。
講演情報
- イベント:Japanese Book History and Digital Humanities Workshop
- 講演日:2026-08-20
- 講演者:北本 朝展(国立情報学研究所)
- 講演資料:Reviving the Saga-bon: Computational Analysis and Public Humanities for 17th-Century Japanese Movable Type
関連リンク
- ROIS-DS人文学オープンデータ共同利用センター(CODH)
- Agentic DH
- A recent experience with ChatGPT 5.5 Pro
- 古版木復刻 武蔵野美術大学造形研究センター「嵯峨本謡本復元プロジェクト」
- 総合書物学-国文学研究資料館
- みを(miwo):AIくずし字認識アプリ
- Sakana Fugu — Multi-Agent System as a Model
- Learning to Orchestrate Agents in Natural Language with the Conductor
- 古活字版の情報学的解析
- 古活字データセット
- 古活字ブロック分析
- 古活字ブロック分析-研究環境
- そあん(soan):古活字画像を用いて現代日本語テキストをくずし字画像に変換/共有するサービス
- そあん(soan):古活字画像を用いて現代日本語テキストを描画するライブラリ
- edomi 学び
- そあん(soan)ボット - LINEでくずし字トーク
この記事は、講演記録を基に生成AIを利用して作成したユースケース記事です。