はじめに
本講演は、国立歴史民俗博物館の橋本雄太氏が第27回CODHセミナーで行ったものです。橋本氏はソフトウェア開発を専門とし、歴史災害やGISの分野は専門外だと述べました。講演では、大量の歴史資料のデジタルテキストから構造化データを取り出すという課題に対して、橋本氏が取り組む2つの事例を紹介しました。1つは『天保郷帳』の地理データ化、もう1つは歴史資料のためのテキストレポジトリの構築と、その安政江戸地震史料への試験的な適用です。どちらの事例でも生成AIを作業に取り入れています。
古文書の翻刻データを地名データと結びつけたい方、歴史資料のアノテーションやエンティティリンキングの基盤づくりに関心のある方、生成AIをデータ構造化に活用したい方に役立つ内容です。
歴史資料の大規模テキスト化と構造化の課題
AI-OCRや、クラウドソーシングによる市民参加型の翻刻が可能になり、大量の歴史資料のテキストデータを入手できるようになりました。橋本氏は、次の課題は、大量の歴史資料のデジタルテキストから研究に有用な構造化データをいかに取り出すかにあると述べました。また、生成AIがデータ構造化の作業に非常に有用であることが経験的に分かりつつあり、データ構造化の方法を変えつつあると述べています。
『天保郷帳』の翻刻と表データ化
『天保郷帳』は、天保年間に幕府の命で作成された全国規模の郷帳です。基本的に国ごとに1冊があり、国の中にある村の名前と、村ごとの生産高(石高)が記載されています。全冊が現存しており、国立公文書館が原本85冊をデジタル化して公開しています。
橋本氏が運営する「みんなで翻刻」は、市民参加型のクラウドソーシングで古文書をデジタルテキスト化するプラットフォームです。2024年までに、みんなで翻刻で『天保郷帳』の8,000コマを全文翻刻しました。それ以来、橋本氏は『天保郷帳』の地理データ化に取り組んでいます。
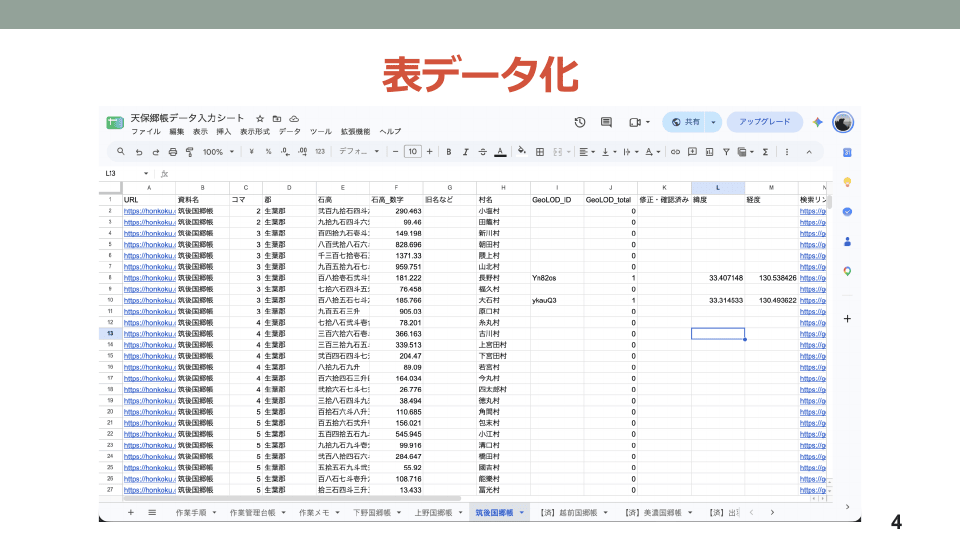
翻刻したテキストには、村の名前と、漢字で書かれた生産高が並んでいます。橋本氏は正規表現を使って、これをGoogleスプレッドシート上で1つの村が1行に対応する表データにしました。シートには村名や石高のほか、GeoLODのIDや緯度・経度の列も設けています。
『日本歴史地名大系』地名項目データセットとの対応付け
橋本氏は、地名情報処理基盤GeoLODのAPI(GeoLOD API)を利用して、『天保郷帳』の各村と『日本歴史地名大系』地名項目データセットとの対応付けを進めています。このデータセットの地名には緯度経度が含まれているため、1対1で対応付けられれば、『天保郷帳』の村にも緯度経度が付き、地理データ化できるという考え方です。
この対応付けに期待されることは、次の2点です。
- 各村に緯度経度が付与されることで、天保年間の生産高の空間的分布を把握できるようになる
- 大系のデータをキーにして他の郷帳データと連携すれば、生産高の時代的な変遷も把握できるはずである(連携先の例:幕末期近世村領域データ、旧高旧領取調帳、慶長郷帳、正保郷帳、元禄郷帳)
対応付け作業の問題:同名地名と表記揺れ
対応付けは、簡単ではありませんでした。『天保郷帳』には約6万の村名が含まれており、そのうち同名が2件以上ある村名は6,933種、行数にして34,394行で、全体の56.8%にあたります。たとえば田中村は全国に104村あり、14郡では同じ郡の中に複数の田中村があります。中野村は全国に142村あり、18郡では同じ郡の中に複数の中野村があります。
データソースによって村名の表記が揺れるという問題もあります。たとえば「駒方新田」と「駒形新田」、「二郎塚新田」と「仁良塚新田」のような違いです。そのため単純な文字列の一致ではうまく対応付けができず、一方で約6万の村名をすべて人手で確認するには膨大な手間がかかります。
ルールベースによる絞り込み
橋本氏が利用したのは、『天保郷帳』では地理的に隣接する村が並べて記載されるという性質です。GeoLOD上で同名の地名が複数ある場合に、次の方法で候補を絞り込みました。
- 直前に記載された村の対応付けが完了している場合に適用する
- 直前の村の座標を中心に、半径10km以内でGeoLOD APIを使って同名の村を検索し、その結果を候補とする
- 候補を1件に絞り込めたら、対応する地名として確定する
この結果、地名全体の68.6%(41,553件)について、候補を1件に絞り込めました。残りの31.4%(19,048件)は人手で突き合わせることになりました。人手の確認はアルバイト3人の体制で進めていますが、3年経ってもまだ終わっていません。
AIエージェントが発案したスコアリング制
人手の確認が終わらない中、橋本氏はAIを使えばさらに絞り込めるのではないかと考え、Claudeに絞り込み方法の改善を頼みました。AIが提案したのがスコアリング制です。手順は次の3段階からなります。
候補を集める
8万件の辞書から、引ける候補をすべて出します。表記の完全一致のほか、別名(歴史地名)での一致、別表記・読みでの一致、「村」を外しての一致も候補にします。従来のルールでは半径10km内の最も近い1件だけを見ていましたが、同名の村が多い表記では候補も多くなり、中野村では最大21件になります。
手がかりごとに点数を足し引きする
候補ごとに、その村と読める根拠があれば加点し、疑う根拠があれば減点します。
- 加点:表記が完全一致(+1.0)、別名で一致(+0.6)、参照点と2km以内(+1.2)、現住所が一致(+1.0)、県が一致(+0.8)、石高が一致(+0.5)
- 減点:参照点や郡の重心から遠い(距離に応じて連続的に減点)、その国に出ない県(−2.0)、辞書が「位置不確か」としている(−0.8)
参照点には、幕末村点データと旧高旧領取調帳を用います。また「該当なし」を選ぶ場合の点数(−3.2)を設け、どの候補もこの線を超えなければ空欄にします。
郡ごとに全体で最高点を選ぶ
村を1つずつ決めるのではなく、郡ごとに全体で解きます。郷帳の記載順を系列とみなして動的計画法を用い、隣り合う村が遠ければ減点します。これにより、後ろにある確実な村が、前にある曖昧な村を訂正できます。同じIDが2つの村に付かないような調整も行います。
最後に、1位と2位の点差(次点差)で人手確認の要否を振り分けます。候補が1件で信頼度0.5以上の場合と、候補が2件以上で次点差が4.0以上の場合を「確定」とします。
結果と検証
人手確認なしで「確定」にできたのは、60,601村のうち47,126村(77.8%)でした。この確定が正しいかを確かめるため、すでに人手で対応付けた村を検証データとして比べたところ、2,129行のうち不正解だった確定は16件(0.75%)でした。橋本氏は、完璧ではないものの人手による結果をほぼ再現できていると見ており、現在はこの方法を採用しています。スコアリング制の導入により、人手で確認が必要な件数は1.9万件から1.3万件に減り、100万円以上の経費減になりました。
AIによる改善が機能した理由とループエンジニアリング
この絞り込み方法の考案で橋本氏がしたのは、絞り込み方法の改善をAIに頼むことだけでした。橋本氏は、AIによる改善が成功した理由として次の2点を挙げました。
- 人手による検証データがあったため、人間が具体的に指示しなくても、AIがさまざまな方法で候補の絞り込みを試せた
- 施策の効果を即座に検証できたため、AIが高速にPDCAサイクルを回せた
橋本氏は、ここでは一種のループエンジニアリングが実現できていたのではないかと述べました。ループエンジニアリングは、AIとの生成・評価・改善を繰り返し、より良い結果に収束させるための設計・運用手法です。橋本氏によると、従来の生成AIの使い方は、人間がAIに比較的具体的な命令を与えるものが一般的でした。これに対してループエンジニアリングでは、人間はAIがタスクをどれだけうまくこなしたかを評価する仕組みを用意し、AIはその評価結果が良くなるようにPDCAサイクルを自律的に回します。橋本氏は、人間が命令するより、AIに自律的に仕事をさせたほうがタスクの精度が上がるほど、今のAIは賢くなっていると見ています。
れきちず上での石高分布の可視化
対応付けの結果を使い、橋本氏は『天保郷帳』の村の石高を、同時代の地図である「れきちず」の上に重ねた「天保郷帳 石高マップ」を作成しました。円の面積が石高に比例し、『日本歴史地名大系』の地名ラベルも表示できます。名寄せが合っていれば、郷帳の村がこのラベルに重なります。
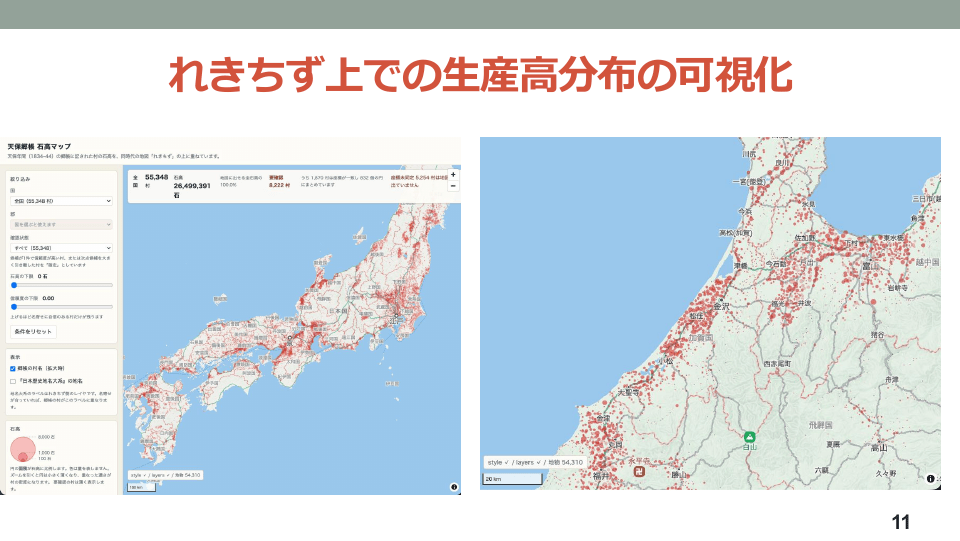
橋本氏は、この地図を点ベースの単純な可視化だと述べました。現在も人手による確認作業を続けており、橋本氏は年内に一通り終えたいとしています。また、まだ間違いがあるため、検証作業が必要になると見ています。
歴史資料の構造化プロセスと「みんなで注釈」
橋本氏は、『天保郷帳』の地理データ化も一種の構造化データづくりだと述べました。歴史資料の大多数は、構造化されていない自然言語で書かれたデータです。機械処理に適した構造化データにするには、次のような段階的な加工が必要です。
- 資料をデジタルスキャンして画像にし、翻刻してプレーンテキストにする
- テキスト中の地名や人名などの重要情報にアノテーションを付ける、あるいは固有表現抽出で抜き出す
- アノテーションした部分を外部のデータソースと対応付ける(エンティティリンキング)
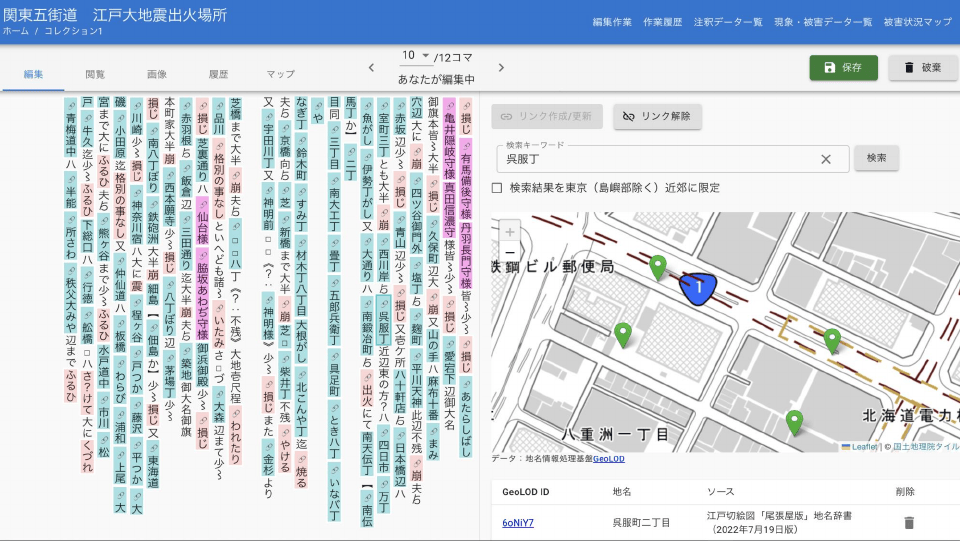
「みんなで注釈」は、橋本氏が3、4年ほど前に作った、歴史災害史料を対象とするクラウドアノテーションシステムです。みんなで翻刻で翻刻された安政江戸地震の関連資料約100点を対象に、ユーザーが人名・地名・地震による被害などをマーク付けし、マーク付けした部分を外部のデータソースと結びつけるエンティティリンキングを、ウェブ上で行えるようにしました。地名はGeoLODのAPIを使って歴史地名のデータと結びつけ、地震の被害がいつ、どこで、どの規模で起きたかを構造化データとして取り出す仕組みでした。
テキストレポジトリが必要になった理由と要件
みんなで注釈を作ってみると、拡張性・一般性の面で大きな課題が分かりました。
- みんなで翻刻で翻刻された安政江戸地震史料に特化している
- ユーザーが任意のテキストを追加できない
- アノテーションやエンティティリンキングの種別が固定されており、他のプロジェクトには使えない
そこで橋本氏は、さまざまなデータソースから得たテキストを集約・保存し、構造化の各段階で得られるアノテーションやエンティティリンキングの結果を保存し、検索・分析・可視化のための機能を提供するテキストレポジトリが必要だと考えました。要件は次の3つです。
- 歴史資料テキストの保存と版管理(翻刻は修正されて変わっていくため、バージョン管理が必要)
- 注釈・エンティティリンキング結果の保存
- 外部アプリケーションとのAPI連携(テキストの取り込み、閲覧・検索、アノテーション付与、エンティティリンキング、分析・可視化)
3つ目について橋本氏は、これらの作業をすべて1つのシステムにまとめると巨大なシステムになり、拡張性の面でも好ましくないため、各機能を外部のシステムとして別に作り、APIでレポジトリ本体と連携させるのがよいと考えました。
テキストレポジトリのシステム構成
実際に作ったシステムでは、本文・注釈・同定をレポジトリ本体に保存し、アプリケーションはすべてAPI越しに使います。
- レポジトリ本体(正本):PostgreSQL 16に、資料・版・本文(Canonical Text)、注釈、言及・実体・同定リンク、注釈どうしの関係・監査ログを保存します。AIの推測である候補は、確定データとは別の表に置きます
- Backend API:REST+OpenAPIで、型付きクライアントを生成します
- APIで連携するアプリケーション:注釈・エンティティリンキング、分析・可視化、取り込み(翻刻・TEI・PDF・IIIFを変換し、確認してから版を確定する)、閲覧・検索
外部の研究システムも同じAPIを使えるように、OpenAPIを公開します。将来アプリケーションを追加しても、本体の構造は変えません。
安政江戸地震史料への試験適用
橋本氏は、コーディングエージェントのClaude Codeを使ってテキストレポジトリを試験的に実装し、みんなで注釈でアノテーションした安政江戸地震関係史料約100点をインポートしました。講演では、このシステムのデモを行いました。
取り込み・閲覧・版管理
データはプロジェクト単位で保存し、1つのプロジェクトを複数のメンバーで共有できます。資料は、プレーンテキスト、DOCX、PDF、HTML、TEI XMLなどの各種フォーマットで登録できます。本文を編集すると版が上がり、特定の版を選ぶとその版のテキストを閲覧できます。
アノテーションとエンティティリンキング
アノテーション用のアプリケーションは、自身ではデータベースを持たず、APIを介してレポジトリ本体と通信します。左側に資料の本文、右側にClaude APIを使ってAIが提案したアノテーション候補の一覧が表示され、人間は候補が適切か(たとえば、ある記述が地震の被害に関する記述として適切か)を目視でレビューします。手動でのアノテーションも可能です。橋本氏は、UIはまだあまり洗練されていないと述べました。
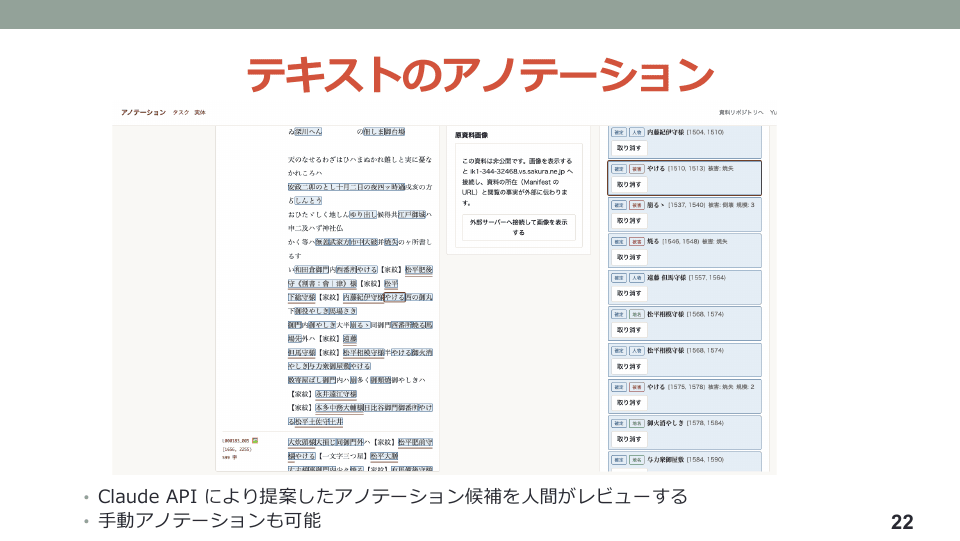
エンティティリンキングは同じアプリケーションの別機能で、アノテーションに対応する実体を検索して登録します。地名は、GeoLODに登録された地名から検索して対応付けられます。AIや辞書が出した候補は未確定の推測であり、選んで初めて確定したリンクになります。
被害状況の可視化
構造化を進めると、アノテーションした場所や地震の被害を地図上に可視化できます。デモでは、安政江戸地震史料に記述された被害の一部を、被害の種別で色分けしてれきちず上に表示しました。橋本氏は、地図上で、大名屋敷が並んでいたと思われる地域や城下町のあたりに火災の記録が多いことが分かると述べました。
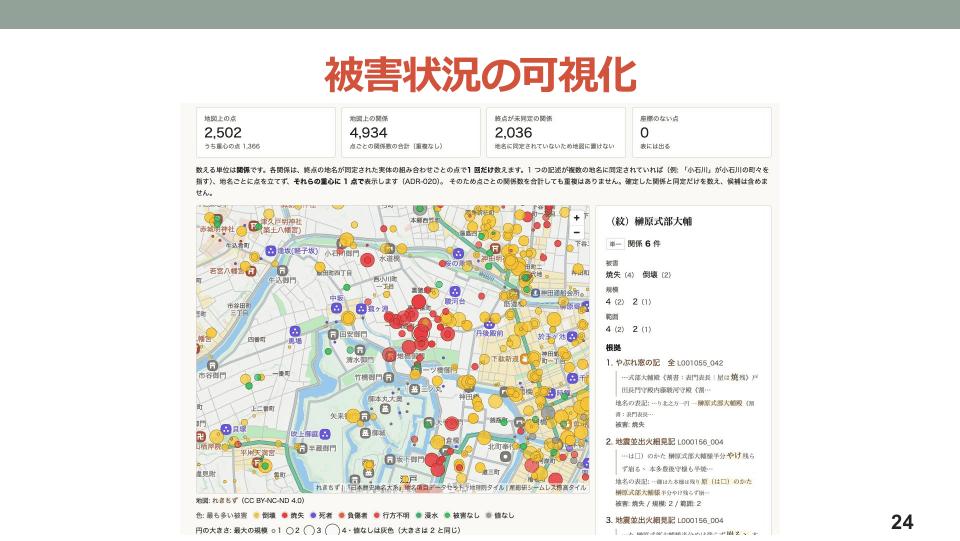
そのうえで、これだけで地震学的に何かが言えるとは限らないものの、地震で何が起こったかのイメージを捉えることは少なくとも可能だとしています。アノテーションの一覧はCSV形式で出力できるため、地震の被害を1件ずつCSVで出力し、他の講演者が紹介したAIによる震度判定にかける手法も可能ではないかと見ています。レポジトリはまだ試験実装の段階で、橋本氏は今後さらに洗練させていく必要があると考えています。
生成AIによるデータ構造化の自動化と展望
橋本氏は、生成AI技術の急速な進化によって、歴史資料から構造化データを抽出する手続きの大幅な自動化・省力化が可能になりつつあると述べました。変化として、次の2点を挙げています。
- 人手によるアノテーションや実体参照から、LLMによる自動認識(ゼロショット)へ
- プロンプトによる具体的な指示から、ループエンジニアリングによるAIの自律的な実行へ
橋本氏は、データ構造化のためのシステムの実装コストもゼロに近づきつつあるとしています。今回試作したテキストレポジトリは、以前であれば人手では数か月でもできず、橋本氏一人ではとても作れなかっただろうと振り返っています。実際、数年前に同じようなものを構想しましたが、実装コストが大きすぎて頓挫していました。生成AIによるプログラム生成が可能になったことで、こうした複雑なシステムを数日単位で作れるようになりました。橋本氏は、大規模な歴史データを集約・加工・分析するプラットフォームを、個人で構築・運用できるようになっていると見ています。
講演情報
- イベント:第27回CODHセミナー - 歴史ビッグデータの作り方と使い方~ データを手作りするプロセスとデジタルツール~
- 講演日:2026-09-18
- 講演者:橋本雄太(国立歴史民俗博物館)
- 講演資料:doi:10.20676/00000485
- 講演動画:YouTube
この記事は、講演記録を基に生成AIを利用して作成したユースケース記事です。