はじめに
大邑潤三氏(東京大学地震研究所/地震火山史料連携研究機構)の講演は、LLM(大規模言語モデル)を使って歴史地震の史料の被害記述から震度を判定するツールを、プログラミングのできない立場から設計・自作した取り組みを扱っています。講演では、史料を一括で処理した第1実験の課題、処理を取得・タグ付け・表化・震度判定に分割した再設計、初回の判定をLLMに監査させる仕組み、第2実験の結果を紹介しました。あわせて、claude.aiとClaude Codeを使った開発の進め方と、人間に残る責任についても述べています。史料の記述をLLMで構造化・数値化したい研究者や、コーディングをせずに研究用のツールを作りたい方に役立ちます。
歴史地震の震度判定とLLMを使う理由
歴史地震の研究のやり方の一つに、古記録に書かれた被害を震度に換算し、複数の地点の震度を地図上に並べて震度分布図を作る方法があります。震度分布図からは、震央はどこか、最も強く揺れたのはどこか、その場所に活断層があり、それが動いたのではないかといった検討を進めます。講演では、2018年大阪府北部の地震で生じた文化財の被害(浄教寺の山門の倒壊:震度5、稲荷神社の石鳥居の倒壊:震度5強)を例に、同じような被害が歴史地震でも起き、山門の倒壊や石鳥居の破損として記録に残ることを説明しました。
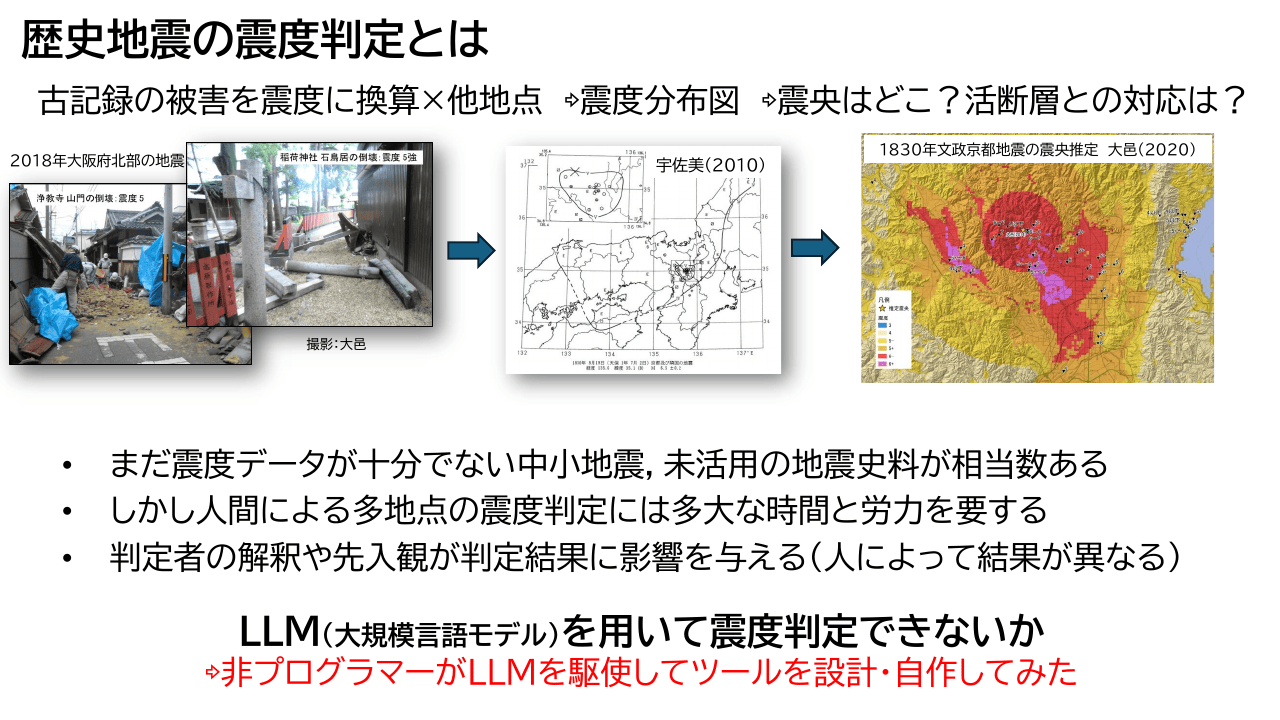
大邑氏が取り組んだのは、震度分布図を作る前の段階にあたる、被害の記述を震度に換算する作業をAIで行うことです。その背景として、次の課題を挙げました。
- 有名な地震では震度のデータが作られている一方、中小の地震には震度のデータが十分でないものが多く、まだ活用されていない地震史料も相当数ある
- 人間が多くの地点の震度を1点ずつ判定するには、多大な時間と労力を要する
- 判定者の解釈や先入観が判定結果に影響し、人によって結果が異なる
そこで、LLMを用いて震度を判定できないかと考えました。大邑氏は、日本史学専攻の出身で地理・歴史的な視点から災害を研究しており、GISは使うもののプログラミングはできないと自己紹介しました。その非プログラマーの立場から、LLMを駆使して判定のためのツールを設計・自作しました。
震度判定表をLLM向けに整理する
ツールの土台には、宇佐美(1994・1995)の震度判定表を用いました。この表は、「池などの水面が少しゆれる」なら震度3、「ほとんどの家が倒れる」なら震度7のように、記述と震度を対応づけたものです。大邑氏は、この震度判定表は、気象庁などの基準に準拠したものを歴史地震に適用して作られた表だと説明しました。従来は、この表を見ながら史料の記述を読み、1地点ずつ地道に震度を判定していました。
大邑氏は、表のままではLLMが読み込みにくく使いづらいだろうと考え、二段階の整理を行いました。
- 箇条書きへの変換:表の内容を指標別の箇条書きに直し、約400件の基準を作りました。指標には、人体感覚、墓石・灯籠など、地変、湖・湖水・井戸など、家屋・建具、寺社、土蔵、石垣、城、田畑、橋・道路、大名・武士の屋敷などがあります
- 3階層への整理:箇条書きのままでも、LLMが基準を選ぶときに使いにくいと考え、大分類(I〜IX)、小分類(A〜R)、項目番号(1〜402)の3階層に整理しました
大分類は、人体感覚、一般住家、大名や武士の住居、寺院・神社、城郭、土蔵・石造物、地盤・自然、農地・橋・道路、地震表記の9つです。LLMは、被害状況から該当する大分類を選び、その中の小分類を選び、さらに小分類の中から史料の記述に最も近い項目を選びます。判定に使った基準は、「III-E-79」(大名や武士の住居で長屋が小破)のように、3階層を組み合わせたIDで示されます。
第1実験:史料を一括処理するアプリとその課題
最初は、この整理で判定できると考え、Anthropic Claude APIのトークンを消費して動作するアプリを自作しました。地震史料集テキストデータベースの史料のURLを入力して「史料を取得」をクリックすると、史料のテキストを自動でダウンロードします。続けて「震度判定」をクリックすると、長文のテキストから地点を抜き出して地点ごとの表を作り、それぞれの震度を判定します。
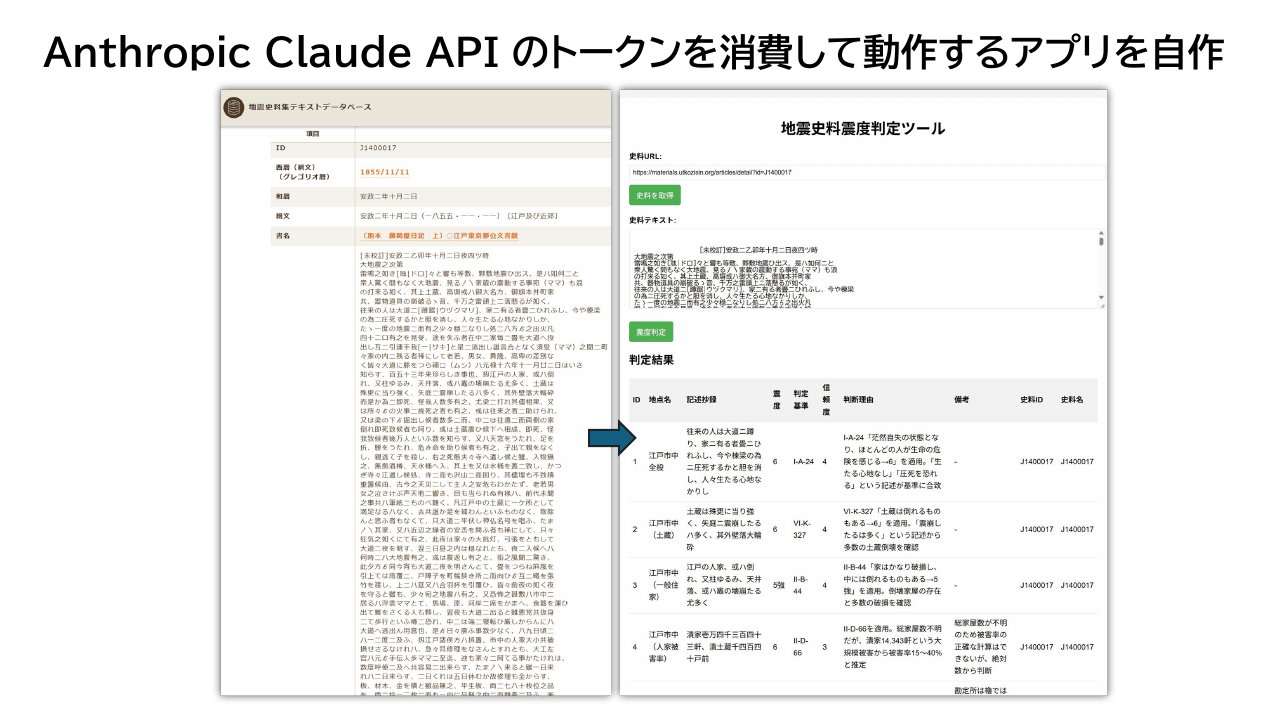
このアプリで、1855年安政江戸地震の史料である別本「藤岡屋日記」上の約2万文字を処理しました。約160地点を抽出し、そのうち140件の震度を判定しました(残る20件は火災などによる被害で判定不能)。大邑氏が確認したところ、160地点中の8割で「適切」「概ね適切」な基準を使っていました(判定不能とした判定を含む)。
一方で、次の課題が明らかになりました。
- 個別の項目の選択に、細かい間違いが散見された
- 加納氏に同じプロンプトで安政江戸地震の史料790件を大量に処理してもらったところ、同じ別本「藤岡屋日記」上でも20か所しか判定しなかった
- 使用した判定基準の妥当性も低下し、「適切」は66%から45%に下がり、「不適切」は5%から15%に増えた
量が増えると取りこぼしが発生し、精度も低下しました。大邑氏は、LLMの特色なのかもしれないと述べ、構造化されていないテキストからいきなり地点の抽出と震度判定の両方を行わせる方式には限界があると考えて、処理の再設計に進みました。
再設計:処理を分割する(取得・タグ付け・表化・構造分析)
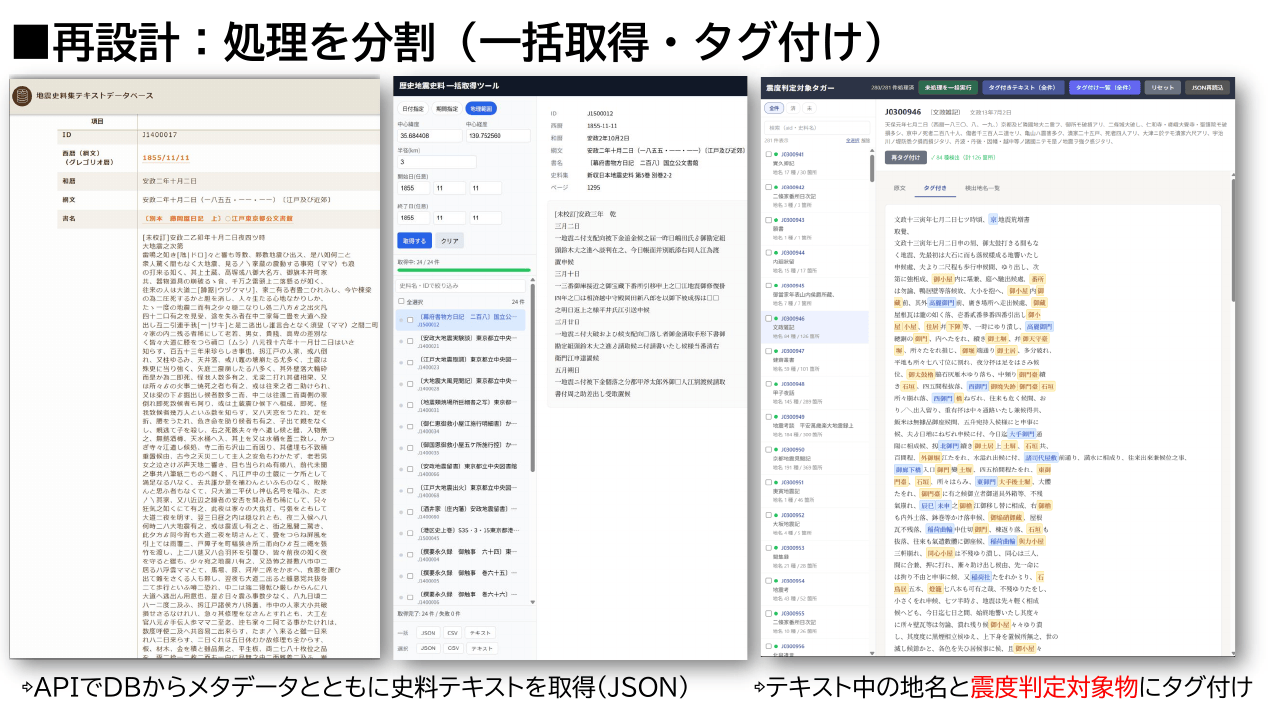
再設計では、処理を段階に分割し、段階ごとにアプリを作りました。判定の前段では、史料の一括取得、タグ付け、表化と構造分析を行います。
一括取得とタグ付け
「歴史地震史料 一括取得ツール」は、APIで地震史料集テキストデータベースから史料テキストをメタデータとともにJSON形式で取得します。取得の条件は、日付指定、期間指定、地理範囲(中心の緯度・経度と半径)から選べます。
次の「震度判定対象タガー」は、取得したテキストの中の地名と、震度判定の対象になる物(構造物など)の2種類にタグを付けます。
表化と構造分析
タグ付けの結果をもとに、地点・対象物ごとに表を作るアプリも作りました。表には、内包史料、大地名、小地名、被害記述、タグの種類、注記が並び、JSONで出力します。このアプリでは、地名や対象物ごとに表にする際に、タグ付けの段階で漏れたものも拾えるように設計しました。
同じアプリで、史料の構造も分析します。本文の中に書状の写しが何通含まれているかといった構造を調べ、JSONで出力します。例えば〔文政雑記〕では、二条城在番御番衆書状(写)など3件の内包史料について差出人とその所在地を整理し、過去の地震への言及など判定から除外する対象も挙げています。
再設計:震度判定・再判定・監査
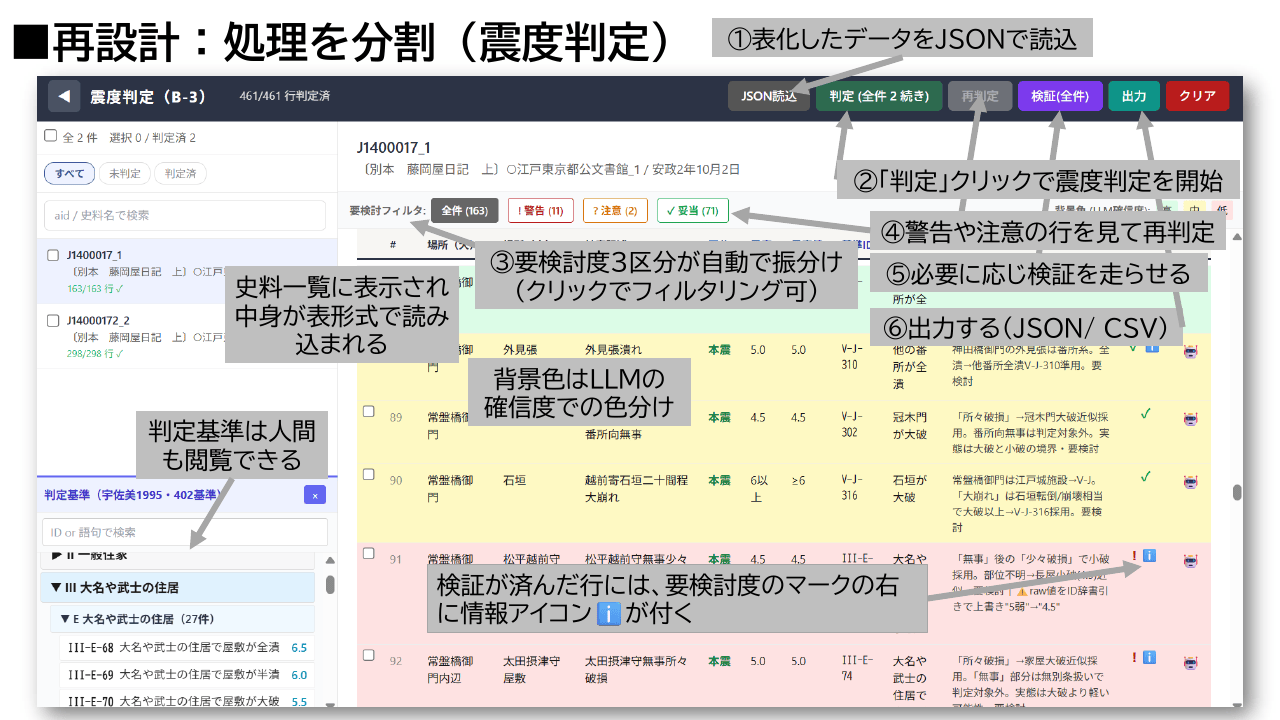
震度判定のアプリは、表化したデータを読み込んで震度を判定します。
震度判定の手順
判定は次の手順で進めます。
- 表化したデータをJSONで読み込む
- 「判定」をクリックして震度判定を始める。1件ずつ判定するため、時間がかかる
- 判定の過程で、要検討度が「警告」「注意」「妥当」の3区分に自動で振り分けられる。区分をクリックすると、その区分の行だけを表示できる
- 警告や注意の行を見て、再判定する
- 必要に応じて検証(監査)を走らせる
- 結果をJSONまたはCSVで出力する
各行の背景色はLLMの確信度を示し、判定基準の一覧は人間も画面上で閲覧できます。検証が済んだ行には情報アイコンが付き、クリックすると検証結果が表示されます。
再判定
再判定の画面では、次のいずれかの方法で判定を直せます。
- 人間が大分類・指標・基準番号をプルダウンで選び、手動で確定する
- 人間がヒントを書き込み、それをもとにLLMに再判定させる
- 人間が「判定不能」(該当基準なし)と判断して確定する
- とりあえずLLMに再判定させる
検証(監査)
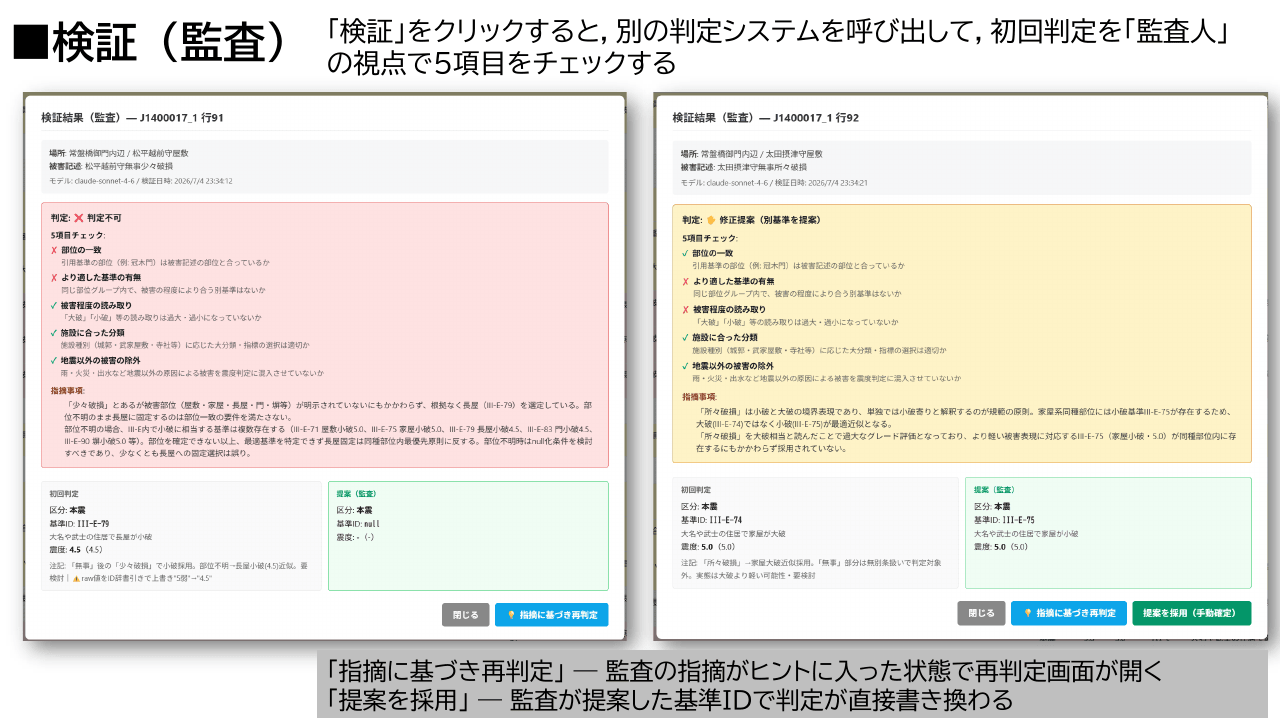
「検証」をクリックすると、別の判定システムを呼び出し、初回の判定を「監査人」の視点で次の5項目についてチェックします。
- 部位の一致:引用した基準の部位が、被害記述の部位と合っているか
- より適した基準の有無:同じ部位のグループ内で、被害の程度により合う別の基準はないか
- 被害程度の読み取り:「大破」「小破」等の読み取りが過大・過小になっていないか
- 施設に合った分類:城郭・武家屋敷・寺社等の施設の種類に応じた大分類・指標を選んでいるか
- 地震以外の被害の除外:雨・火災・出水などによる被害を混入させていないか
例えば「松平越前守無事少々破損」という記述に、初回の判定は長屋の小破(III-E-79、4.5)を当てていました。監査は、被害の部位が明示されていないのに根拠なく長屋の基準を選んでいるとして「判定不可」とし、基準を当てないことを提案しました。「太田摂津守無事所々破損」では、初回の判定は家屋の大破(III-E-74)でしたが、監査は「所々破損」を小破と大破の境界の表現とみて、家屋の小破(III-E-75)を提案しました。
監査の画面で「指摘に基づき再判定」をクリックすると、監査の指摘がヒント欄に入った状態で再判定の画面が開きます。「提案を採用」をクリックすると、監査が提案した基準IDで判定が直接書き換わります。
第2実験の結果
再設計したツールで、第1実験と同じ別本「藤岡屋日記」上の約2万文字を処理しました。抽出した被害記述は、第1実験の160件から461件へと約3倍に増えました。大邑氏は、タグ付けで地名だけでなく、震度判定の対象になる構造物まで対象に入れたことが大きいと見ています。
461件のうち315件(68%)について震度を判定し、146件は「判定不能」としました。判定した315件について、史料テキストの内容に対して適切な震度判定基準を使っているかどうかをAIが自己判定した結果は、次のとおりです。
- 妥当:264件(84%)
- 注意:4件(1%)
- 警告:47件(15%)
人間による確認はこれから行います。大邑氏は、注意と警告の行は人間による再判定に回すとし、その程度の件数であれば人間が対応できるだろうと述べました。
大邑氏は、今後、史料の性格を判定結果に反映できないかと考えています。対象は、記主の在地性、伝達経路、史料の成立時期です。例えば、記主の所在地から遠い場所の被害の記述は信頼性が低いのではないか、伝達経路が伝聞ではないか、史料の成立時期が地震発生から時間的に離れていないか、といった点を判定結果に反映することを考えています。
開発の進め方:設計と実装の分業
大邑氏は、AI(Claude)と壁打ちをしながらツールを作りました。
設計と実装のループ
開発は、次の4つを行き来する形で進めました。
- claude.ai(設計・壁打ち):判定の規則や監査の方法を対話で決める
- CLAUDE.md(仕様書):決まった設計を文章にして実装側へ渡す
- Claude Code(実装、VS Code上で対話):コードを書かせ、動作を確認する
- アプリ(実行・結果確認):史料を流して処理結果を確認し、問題があればclaude.aiに戻って設計を直す
開発では、変えてよい範囲を明示すること(例:「判定基準表は一切変更しない」)と、頼んでいない「改善」をさせないことに気をつけています。LLMは親切心から、指示していない箇所まで「ついでに」直すことがあるためです。
指示書の例として示した判定アプリの改修指示書では、江戸を前提とした施設種別ルールでは京都の御所・公家屋敷などに対応するカテゴリがなかったため、こうした支配層の邸宅に原則としてIII-E(大名や武士の住居)を準用することを定めました。
壁打ちの実例:監査の仕組みに至るまで
判定結果を精査すると、初回の判定に誤りとぶれが残っていました。同じ被害記述に別の基準が付いたり、「要検討」が判定した行の87%に付いて仕分けの役に立たなかったりしました。
最初に考えたのは、初回の判定結果を渡さずにもう一度判定させ、結果を突き合わせる再判定(blind)でした。1回目と2回目で答えが割れた行は人間が見る対象にできますが、同じ基準・同じモデルで判定するため、毎回同じ基準を選んでしまう行は見つけられずに通ってしまいます。そこで、同じことを2度行うのではなく、初回の判定を渡して別のルールで点検させる監査(audit)を採用しました。部位の一致、被害程度の読み取りなどの5項目をすべて通過しないと「妥当」にしないことで、初回の判定の追認を防ぎます。確かめ方として、既知の誤判定(「与力小屋四軒潰」にIII-E-76を当てたもの)を監査させ、より適したIII-E-84が挙がるかを試しました。
人間とClaudeの分担
大邑氏は、人間とClaudeの分担を次のように整理しました。
- 人間(大邑氏)が判断して文章にしたもの:判定基準表の箇条書き化と階層の整理、タグ付けの対象(地名と構造物)の定義、施設の準用ルール(公家屋敷は大名屋敷に準じる)、監査で点検する5項目(対話の中で決めた)、変えない範囲を明示した指示書
- Claudeがコードとして実装したもの:判定アプリ(約2,900行)と取得ツール、一覧・色分け・絞り込みなどの画面、JSON・CSVの読み込みと書き出し、APIの呼び出しと中断・再開、基準IDの実在チェックと値の照合
大邑氏は、コーディング力が不要とまでは言わないものの、LLMの提案を判断し指示する力があれば、こうしたツールを作れるのではないかと述べました。ただし、結果を確かめ、責任を負うのは人間であるとしています。
限界と人間に残る責任
大邑氏は、限界として次の5点を挙げました。
- 読めないコードの保守:コードを書けないため、壊れたときに自力では直せない
- モデルの更新と再現性:LLMのモデルは日々更新され、同じ入力でも結果が変わりうる。そのためモデル名と日時を記録している
- 費用とアクセス:APIの利用料がかかり、誰でも同じ条件で使えるわけではない
- 大量に処理できることは、誤りも大量に生むこと:第1実験では、件数を増やすと適切な基準の使用が66%から45%に下がった
- AIの説明が冗長・難解で、理解が追いつかない:AIの説明を理解するのも骨の折れる作業だった。分かったつもりで採用せず、分かるまで聞き直す
そのうえで、人間に残る責任として、何を変えないかを決めること、結果を史料で確かめること、AIの提案の採否を決めることの3つを示しました。大邑氏は、こうしたあり方が「Historian in the Loop」になっているのではないかと述べました。
今後の展望
大邑氏は、歴史地名辞書を用いて地名に座標を付与できれば、震度分布図を作れるようになるという展望を持っています。地名に緯度・経度を付与する資料として、本田(2024)の幕末期近世村領域データ、『日本歴史地名大系』地名項目データセット、橋本(2023〜)の天保郷帳の地名辞書などを挙げました。AIによる震度判定については、AIが判定して人間がチェックする形式(AIとの対話型)であることと、注意点として、記述を細切れにすると文脈が失われること、LLMが解釈できない独特の言い回しや状況があるため人間の補足が重要であることを挙げています。
講演情報
- イベント:第27回CODHセミナー - 歴史ビッグデータの作り方と使い方~ データを手作りするプロセスとデジタルツール~
- 講演日:2026-09-18
- 講演者:大邑潤三(東京大学地震研究所/地震火山史料連携研究機構)
- 講演資料:doi:10.20676/00000484
- 講演動画:YouTube
この記事は、講演記録を基に生成AIを利用して作成したユースケース記事です。