はじめに
東京大学地震研究所/地震火山史料連携研究機構の加納靖之氏による講演です。地震火山史料連携研究機構は、地震研究所と史料編纂所が共同研究を行うために設けたバーチャルな部局です。講演の前半では、江戸時代以前に起きた歴史地震の研究に関わるデータとして、地震史料集を電子化した地震史料集テキストデータベースや震度分布のデータについて、後半では1855年安政江戸地震の被害と震度のデータセットについて取り上げました。史料の記述をテキストにし、地名にIDや緯度経度を付けて地図上で分析するまでの具体的な取り組みと、データクリーニング、史料の信頼性、利用条件の明示といった課題を知りたい方に役立ちます。
歴史地震の震度分布図をつくる
加納氏が目指すのは、現代の地震であれば気象庁がすぐに公表するような震度分布図の歴史地震版を数多く作ることです。講演では例として、2026年9月17日0時07分に茨城県南部で発生した地震(マグニチュード4.8、震源の深さ70km)の震度分布図を示しました。
江戸時代以前の地震では、当時の人々が体験して書き残した文書の記述をもとに推定します。家が倒れた、強く揺れた・弱く揺れたといった記述を震度の尺度に変換して地図にすると、強く揺れた範囲の中心付近に震央があると推測でき、その広がりから規模(マグニチュード)をある程度推定できます。そのために、くずし字で書かれた史料を翻刻してテキストデータにし、現代語訳しながら被害や揺れの記述を抜き出します。講演では、「夜四ツ時過ゟ大地震にはかにゆり出し」という翻刻を「夜四ツ時(午後十時頃)過ぎから大地震で急に揺れはじめた」と現代語訳する例を示しました。こうして震度データ点(被害や揺れの程度がわかる情報のある地点)や地震カタログを作り、震央の位置や規模の推定につなげます。
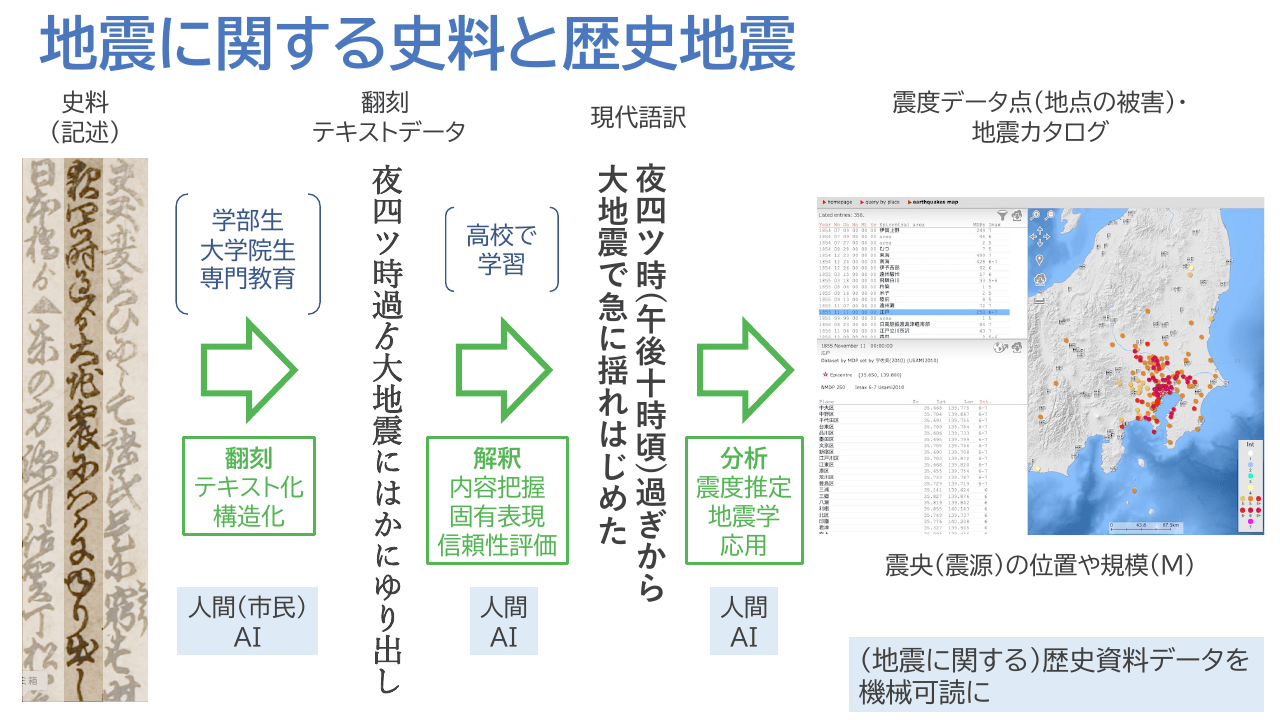
史料からは、いつ・どこで発生したか、被害や揺れの分布、何が起きたか(被害の程度・様相、港の水深変化や井戸水の変化といった揺れ以外の情報、人々や社会の対応)を知りたいと加納氏は述べました。「いつ」についてはIDを付けて規格化したいこともあり、HuTime(時間情報解析ソフトウェア)のような基盤が使えるのではないかと考えています(地震史料集テキストデータベースの実装に利用しています)。「どこ」の情報は重要で、GeoLODなど地理的なデータセットやIDの体系にひも付けられるとよいと述べました。震度への変換は後で大邑潤三氏が紹介すると思うとして、加納氏はこの講演では省きました。加納氏は、地震で何が起き、人々がどう対応したかという歴史学の範疇の情報にも関心があり、将来起こりそうなことを考える防災の観点からも大事だと述べました。
地震史料集の編纂とデータベース化
明治の濃尾地震の後に設けられた震災予防調査会(1892)が地震史料の編纂を目標に掲げ、それ以来、『大日本地震史料』(1904)、『増訂大日本地震史料』(1941-43)、『日本地震史料』(1951)、『新収日本地震史料』(1981-1998)、『日本の歴史地震史料 拾遺』(1998-)と編纂が続いています。『増訂大日本地震史料』は史料編纂所で編纂されている『大日本史料』の体裁にならい、綱文に年月日と地震の場所を記して関連史料を並べる形式です。明治・大正のころは『大日本史料』から地震に関係する部分を抜粋していましたが、昭和から平成にかけてのプロジェクトでは、全国の自治体史などの翻刻本から史料を抜粋したほか、自治体史編纂で調査中の活字になっていない史料も見せてもらうなどして、史料集として刊行しました。
史料集を電子化して検索可能にする取り組みは、[古代・中世]地震・噴火史料データベース(β版)、ひずみ集中帯プロジェクト、首都直下に着目した都市の脆弱性が引き起こす激甚災害の軽減化プロジェクトなどで、時期や地域を区切って行われてきました。最近になって地震火山史料連携研究機構で、既刊の地震史料集をまとめてデジタル化し公開しました。さらに、日記史料有感地震データベースも公開しています。
地震史料集テキストデータベース
地震史料集テキストデータベースは、既刊の地震史料集35冊・約27,700頁をテキストデータにしたもので、約6.7万件・約2,400万字・143MBの規模です。加納氏は、学生に35冊を全部読んでから研究しようということだとなかなか大変なので、検索できることを大事にしたと述べました。本文のキーワード、年月日、一部の地名、緯度経度で検索できます。
テキスト化とデータのクリーニング
テキストデータは、OCR・高精度テキスト化と手入力で作成しました。20年ほど前からの長期のプロジェクトで、出版関係の会社に外注してテキスト化やXMLによる構造化を行い、費用と時間をかけてきました。それでも、データベースにすると誤字・脱字、XML構文ミス、版面の構造や例外による誤り、もとの史料集の誤りなどがあり、検索できるようになると粗が目立ちました。公開から5年、現在もデータのクリーニングを続けています。加納氏は、テキスト化は当時より低コストでできるようになったはずだと見て(AI-OCRで相当安価になるか、クリーニングにもAIを使えるかを問いの形で挙げています)、テキスト化できるものは進め、地震に関するものはこのデータベースに統合したいと述べました。
地名へのIDの付与
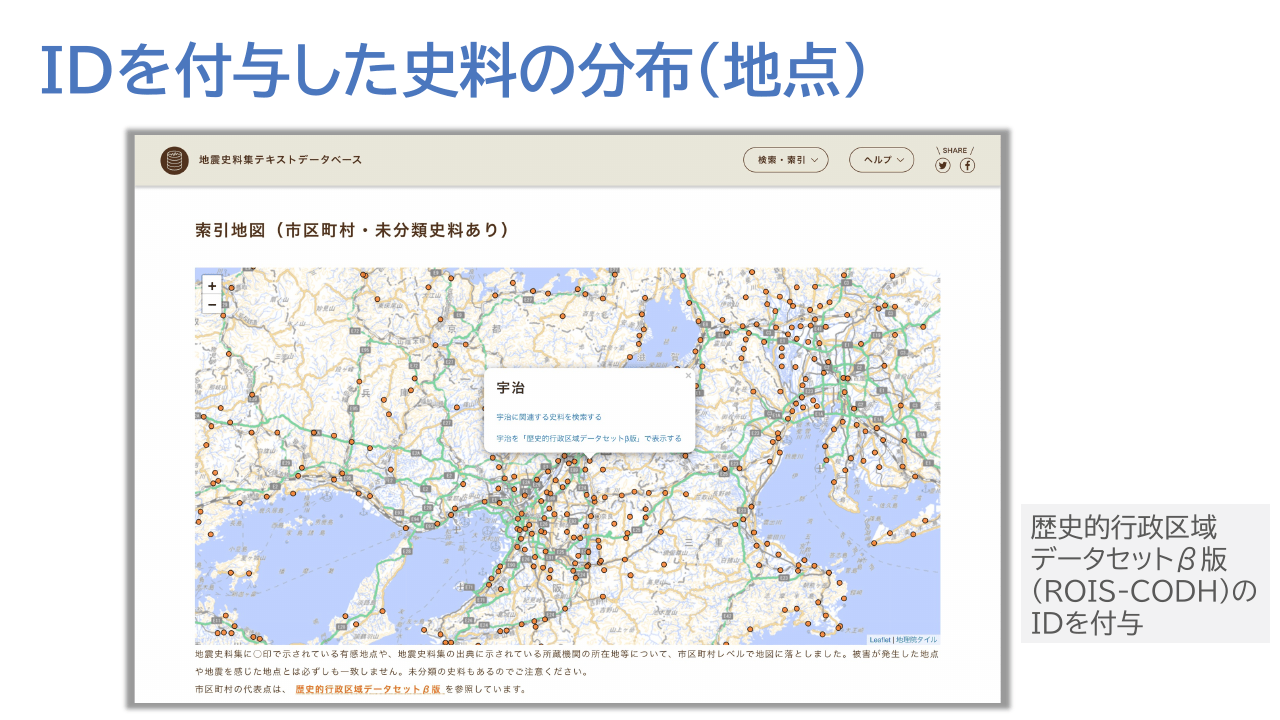
史料集には、自治体史の書名や、地震史料集に〇印で示されている有感地点(例:〇高山)など、さまざまな箇所に地名が現れます。本文の地名に座標を当てるのは大変な作業であったため、初期段階では、〇印の地名と書名の地名に、ROIS-CODHの歴史的行政区域データセットβ版の地名IDを付与しました。例えば〔石川県中島町史 資料篇〕の書名からは、石川県鹿島郡中島町(17403A1968)のIDが付きます。
これにより、索引地図で例えば「宇治」をクリックすると、宇治に関連する史料を検索できます。ただし、地図上の地点は〇印の有感地点や出典の所蔵機関の所在地などを市区町村レベルで落としたもので、被害の発生地点や地震を感じた地点とは必ずしも一致しません。また、地名が付いたのは一部の史料に限られます。綱文の地名は書名・本文に含まれるため対象とせず、本文の地名は読まないとわからないため、今後、人力やAIなどで付与する予定です。
『新収日本地震史料』の編纂資料
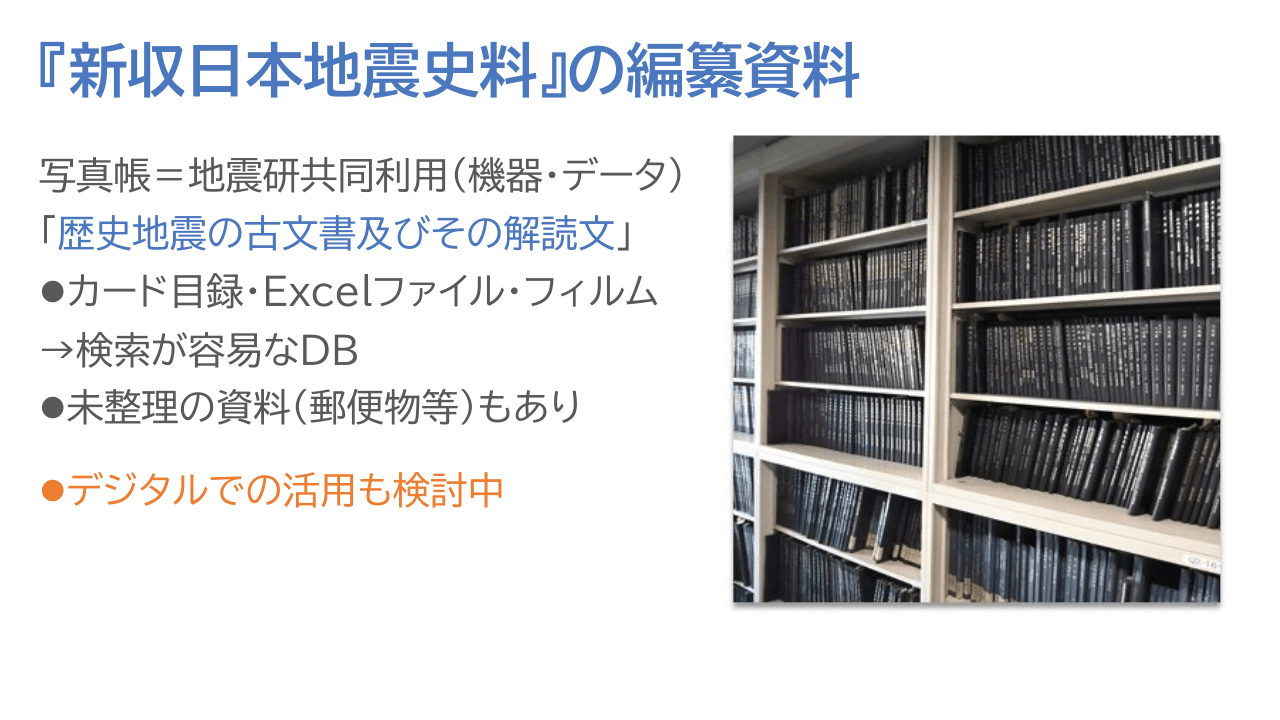
『新収日本地震史料』には、編纂の中間生成物にあたる資料が残っています。調査先でコピーや写真撮影をさせてもらった史料を紙焼きにして冊子に綴じたもので、写真帳と呼んでいるものです。写真帳は「歴史地震の古文書及びその解読文」として地震研究所の共同利用(機器・データ)の対象です。カード目録とそのExcelファイルから、いつどこでどの史料を集めたかがおおよそわかります。未整理の資料(郵便物等)もあり、加納氏は整理して最新のものまで追いつけたらと述べました。写真帳のもとになったフィルムも残っており、全部スキャンしてデジタルで写真帳を見られるようにする作業を進めています。加納氏は、調査先ではすでに所在がわからなくなっている史料もあると聞いており、その意味でもコピーが残っていることには重要な面があると述べました。
『新収日本地震史料』第1巻のはしがきには、新収史料が多量で予算が十分とはいえないため全体の印刷が難しいこと、未発見の地震史料は膨大で、この仕事が完成することはありえないと考えられ、永く続けなければならない仕事であることが書かれています。加納氏は、デジタルの時代には出版の面での制約が少し緩くなっているとして、史料を発見して使いやすい状態にしていくことを今後も長く続けていかなければならないと心に留めていると述べました。
史料集データベースの今後
史料集データベースの今後として、加納氏は史料校訂の反映、新出史料の追加、種々の資料やデータベースとのリンクの3点を挙げました。
史料校訂の反映
史料集はある意味手当たり次第に史料を集めており、玉石混交とも言われ、歴史学の常識からすると問題のある史料も含まれます。現在、史料編纂所で史料の校訂を進めています。信頼性の低い史料を避けたり翻刻の誤りを直したりしたデータセットができるので、加納氏はそれを統合することを考えています。登録方針(案)では、未校訂と校訂済のデータをひもづけるとしています。加納氏は、玉石混交でもとにかく多く見たい人もいると考え、完全に入れ替えるのではなく両方見えるようにしたいと述べました。
新出史料の追加
大邑氏らが最近述べているように、史料集として出版するのは大変でも、1点の史料であれば機関リポジトリに登録して公開できます。その例として、個人が入手した新出史料を、古地震研究会の合宿での「みんなで翻刻」による多人数翻刻(翻刻参加者12名)とAIによるくずし字OCRで解読し、史料概要・翻刻文・史料画像をPDFで東京大学の機関リポジトリに公開した事例(大邑・他(2026))を示しました。この事例は、地震史料集刊行の営みを継承するモデルケースとして示されています。加納氏は、こうしたリポジトリや個々の研究論文に出てくる新しい史料も統合していけるとよいと述べました。
種々の資料やデータベースとのリンク
現在は、写真帳に戻るには、データベースで調べた書名をもとに写真帳の部屋に行くしかなく、加納氏はうまくリンクしてたどりやすくしたいと述べました。90年代後半ごろから、XMLでの構造化、地名辞書とのひもづけ、もとの史料の写真とのリンクなどが構想されていました(都司(1998)・岩崎(1999)、原(2005))。手間や計算機の性能、周辺のデータベースの整備の遅れなどから実現が難しかったものの、加納氏は、今では地理院地図やれきちずのような歴史地図に自分たちのデータをきれいに描けるなど、いろいろなものをリンクしやすくなってきたので、その状況を活用していくとよいと述べました。
宇佐美(2010)の震度分布データと関東地方の震度データベース
宇佐美(2010)の震度分布データは、宇佐美龍夫編著『わが国の歴史地震の震度分布・等震度線図(改訂版)』(2010年)を渡辺健氏が電子化したものを、オンラインデータベースにしたものです。自治体程度の粒度にまとめたデータで、画面例では356件の地震が一覧表示され、1855年11月11日の江戸の地震は震度データ点250、最大震度6-7となっています。課題は、各震度の根拠となる史料とのひもづけができていないことで、加納氏は、よく調べればたどれるので、たどってデータにしていくとよいと述べました。
関東地方については、科研費基盤(B)「歴史地震の震度データベースの構築と関東地方の地震履歴・将来予測の高度化」(研究代表者:佐竹健治)などのもとで、地震史料集テキストデータベースと日記史料有感地震データベース・調書を合わせ、震度データや史料・先行研究とのリンクを扱うデータベースを作っています。主な史料の本文から水野嶺氏・吉岡誠也氏らが抜き出した地名を使い、関東地方で起きた地震に関する地名のデータセットを作っています。加納氏は、この方法で広げていくか、既存の地名辞書で機械的に処理するかを考えているところだと述べました。地震史料集テキストデータベースとの統合では、現在ひずみ集中帯プロジェクトの数件の史料に地名が付与されており、加納氏は江戸地震の分を増やすことができるとうれしいと述べました。
安政江戸地震の震度分布データセット
宇佐美(1995)「安政江戸地震の精密震度分布」の表を、中村・他(2019)、石瀬・他(2021)がエクセルに入力したデータセットがあります。完全に公開されているわけではありませんが、「むかしの地震の被害のデジタルデータ」として地震研究所の共同利用で利用できます。内容は地点名・震度(宇佐美の表)、緯度・経度(歴史的行政区域データセットβ版を参照)、史料集・ページです。加納氏は、最近行ったこととして、地震史料集テキストデータベースの史料IDへのひもづけと、地点名を標準化するためのGeoLODとのリンクを挙げました。もとの表は、江戸城の西丸(震度Ⅵ)のように、場所と震度が対になった形式です。安政江戸地震に関するデータとしては、ほかに江戸・安政災害キュレーションなども挙げています。
地図化と地盤増幅率との重ね合わせ
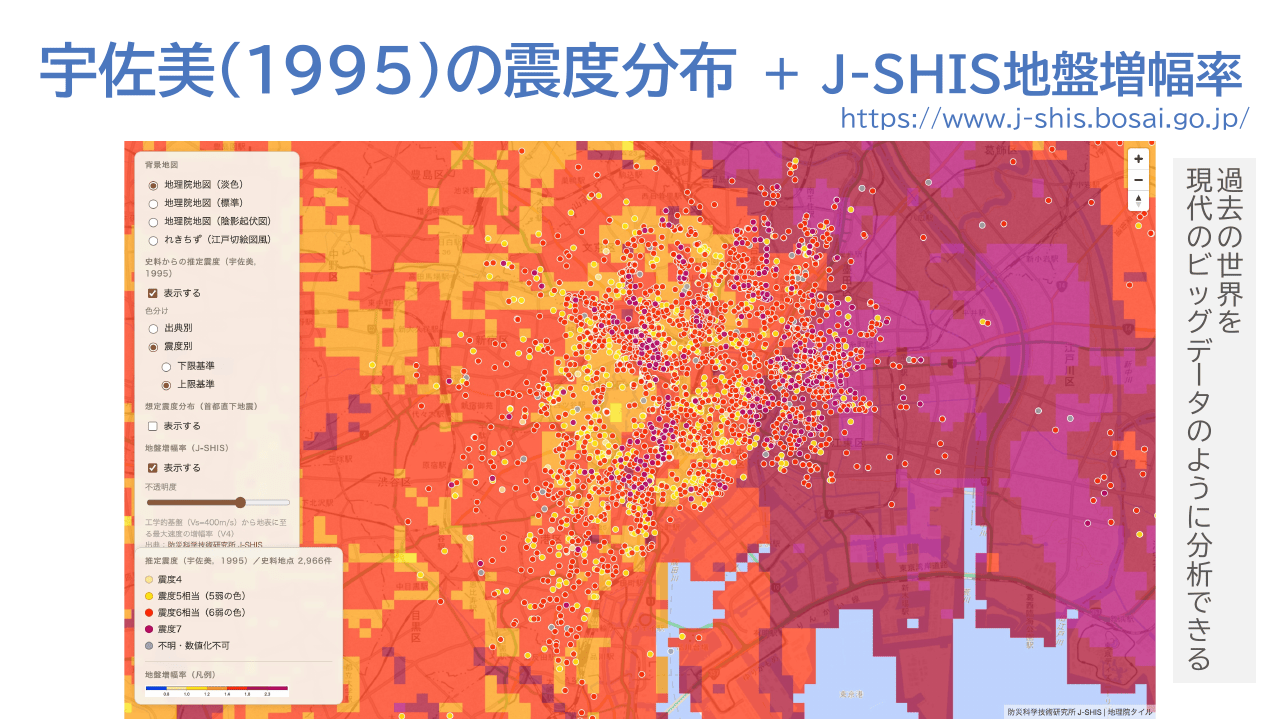
地名に緯度経度を当てて地図にすると、史料からの推定震度(宇佐美,1995)の史料地点2,966件が、震度4、震度5相当、震度6相当、震度7、不明・数値化不可に分けて表示されます。背景地図や想定震度分布(首都直下地震)、地盤増幅率を重ねて表示できます。
J-SHISの地盤増幅率(工学的基盤(Vs=400m/s)から地表に至る最大速度の増幅率)を重ねると、加納氏は、強く揺れた地点が谷底低地のような揺れやすい地盤となんとなく対応しているように見え、東側の低地には震度の大きい地点がより多いことがわかると述べました。加納氏は、これは北本氏が冒頭で述べた、過去の世界を現代のビッグデータのように分析できるという話と関わるのではないかと述べ、地震の揺れのシミュレーションと比較することもできるのではないかと見ています。また加納氏は、地盤増幅率には埋め立てた土地の部分も含まれるので江戸地震の震度分布とは合わない部分もあるとしながら、江戸時代と現在の地盤は変わらない部分も多いと考えられるため、江戸時代に揺れやすく被害が出た所は今も揺れやすく、そこにある耐震性の弱い建物は次の地震で危ないかもしれない、といった考え方ができる地図になると述べました。
れきちずとの重ね合わせ
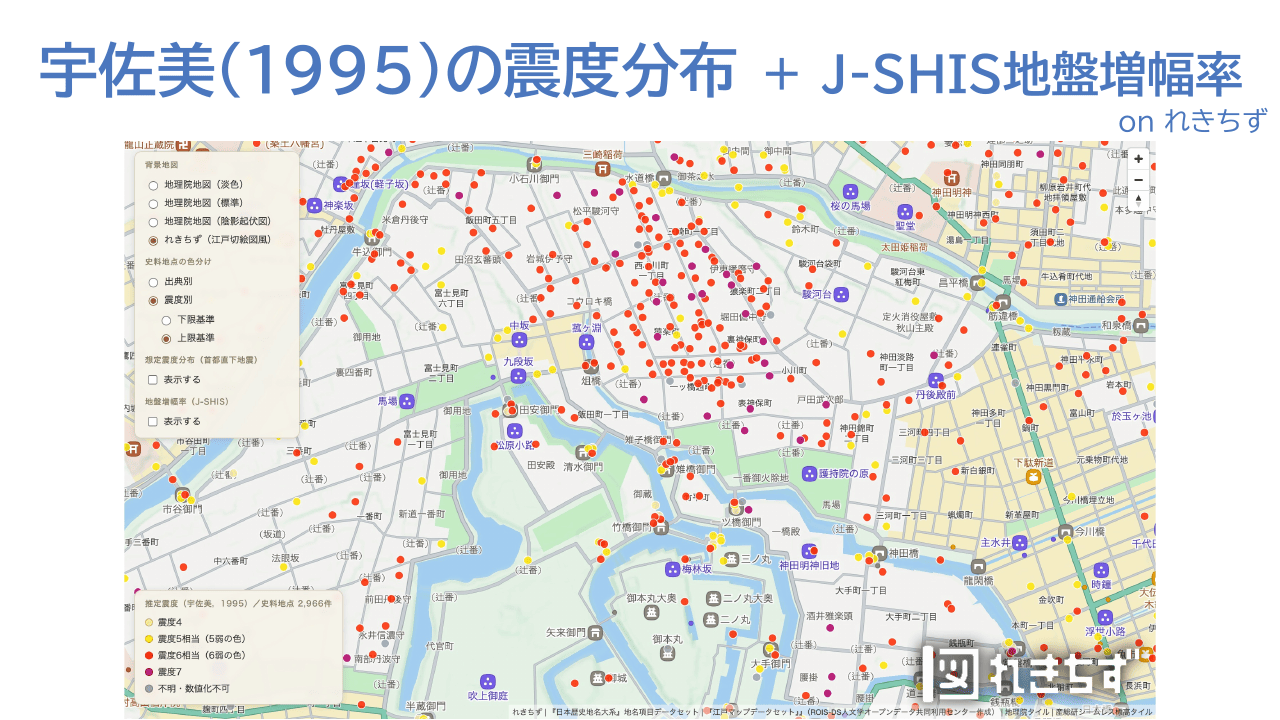
「れきちず」に重ねると、江戸時代になかった埋立地は表示されず、加納氏は、ないものがないように見えるのはよいと述べました。江戸時代の震度は基本的に被害の分布から得られるため、大名屋敷があった所など、家が建っていた所に点が集まります。江戸城の周辺を拡大すると、被害が出ると注目されて史料によく出てくる門や橋に点が集中しており、加納氏は、当たり前といえば当たり前のことが当時の地図と見比べるときれいに可視化されると述べました。
典拠史料の偏り
データセットの根拠となった史料をたどると、震度データの半分ほどが上位5〜6点の史料から抜き出されています。上位は〔安政度地震大風之記〕(899件)、〔別本 藤岡屋日記 上〕(503件)、〔安政江戸大地震〕(309件)などで、いろいろな場所の被害が書き上げられた一覧表のような史料であり、震度の推定に使いやすいものです。加納氏は、歴史学の研究者とも相談しながら、どれがより信頼性が高いか、より使いやすいかを今後考えていく必要があると述べました。
課題と展望
加納氏は、歴史地震研究のためのデータセットを整備中であり、IDや座標を介したデータセット間のリンクを模索していると述べました。写真帳のような中間生成物や作業のログもうまく活用できればよいと考えており、地震学、歴史学、地理学、情報学など分野を超えた協働が必要だとしています。加納氏が挙げた課題は次のとおりです。
- 機械可読でないこと(紙):以前は費用をかけないとよいデータができなかったが、AI-OCRなどAIの助けでかなり手軽になってきた。ただし細かい部分は人が見る必要がある
- 引用の範囲:紙でしかないデータを勝手にデジタル化してオープンにしてよいのかわからない面があり、歯切れが悪くなる
- 中途半端なオープンデータ:これから作るデータは、利用条件を明示しておくと後の人が困らない
- ボーンデジタル:最初からオープンにするつもりで作るデータ(ボーンオープンデータ)が増えていく。その際は標準化が大事で、リポジトリに翻刻を載せる場合などは最初に形式を決めることが大事だと北本氏との議論で聞いた
最後に加納氏は、「手作り」にはそのデータについての理解や関心、愛着があったほうがよいのではないかと投げかけ、データができるのを待つよりも、自分が作れるデータを作ってみるとよく、作ってみないと作り方はわからないと述べました。
講演情報
- イベント:第27回CODHセミナー - 歴史ビッグデータの作り方と使い方~ データを手作りするプロセスとデジタルツール~
- 講演日:2026-09-18
- 講演者:加納 靖之(東京大学地震研究所/地震火山史料連携研究機構)
- 講演資料:doi:10.20676/00000483
- 講演動画:YouTube
関連リンク
- ホーム - 地震史料集テキストデータベース
- 日記史料有感地震データベース
- UTokyo Repository(図書)
- 「甲寅大変記」の概要と翻刻文ならびに史料画像 - University of Tokyo
- 宇佐美(2010)の震度分布データ
- UTokyo Repository(研究調査報告書)
- 江戸・安政災害キュレーション
- J-SHIS 地震ハザードステーション
この記事は、講演記録を基に生成AIを利用して作成したユースケース記事です。