はじめに
国立情報学研究所およびROIS-DS人文学オープンデータ共同利用センター(CODH)の北本 朝展氏による講演の記録です。日本古典籍を対象に、くずし字OCRや人間による翻刻で得たテキストを、大規模言語モデル(LLM)のためのコーパスとして構築し活用する取り組みを扱います。
講演では、LLM利用向けとLLM構築向けのデータセットの品質要件の違いを示したうえで、LLMを古典籍に活用するためのアプリ(つくしチャット、つくし堂)と、共同研究者のカラーヌワット・タリン氏(Sakana AI)が進める、江戸時代の古典籍を学習したLLM「からまる」の事例を紹介しました。後半では、歴史的日本語の文字とテキストの基礎知識と、今後の課題を述べました。歴史的資料のテキストをLLMに使いたい方に役立つ内容です。
つくしプロジェクトの背景と問題意識
国文学研究資料館(国文研)では、1868年以前の日本古典籍30万点をデジタル化し、オープンデータとして公開する大型プロジェクト(DDHプロジェクト)が進んでいます。北本氏は、これによって日本文化のビッグデータができ、それをどう活用するかが取り組みのきっかけになったと述べました。
その取り組みの一つとして、2023年度につくしプロジェクト(Tsukushi project)を立ち上げました。当時の問題意識として、LLMの学習データにおいて、日本語テキスト、特に歴史的日本語のテキストが、量的に少ない低資源言語(low-resource language)の状態になっていた点を挙げました。これを受けて、AIくずし字OCRによる大規模なデータセットの構築と、LLMを古典籍に活用するためのアプリ開発を目標にしています。
歴史的日本語テキストの種類と翻刻データ・OCRモデル
テキストの種類と人間が翻刻したデータセット
講演では、歴史的日本語テキストを、複製されて流通した書籍である古典籍、書状など特定の相手への伝達のための古文書、様々な出来事を書き留める日記や各種の記録類などの古記録の3つに分けました。北本氏は、国文研は主に古典籍を対象とするものの、日本全体では古文書や古記録も膨大な点数があると述べました。
人間が翻刻(テキスト化)したデータセットとしては、次のものを紹介しました。
- 日本古典籍データセット/くずし字データセット(ROIS-DS CODH・国文研・国語研):古典籍のプレーンテキスト約100万文字(CC BY-SA)
- みんなで翻刻(歴博・東大地震研他):市民参加型の翻刻で作られた、古典籍・古文書等のプレーンテキスト約4800万文字(CC BY-SA)
- 日本語歴史コーパス(国語研):奈良時代から明治/大正時代までの注釈つきテキスト(要利用許諾)
このほかにも多くの翻刻テキストがありますが、出版社が権利を持っています。そのため、なかなか使うのが難しい状況にあると述べました。
くずし字OCRモデル
機械が翻刻するくずし字OCRとしては、3つのモデルを挙げました。Metom(Sakana AI開発)は文字単位の認識で、文字を囲むとその中の文字を認識します。RURIは画像単位の認識で、スマホアプリmiwoに使われており、アプリのダウンロードは20万件を超えています。NDL古典籍OCRは画像単位のオープンソースのソフトウェアで、国文研はこれを使って古典籍を大規模にテキスト化しています。
LLM利用向けとLLM構築向けのデータセットの違い
北本氏は、OCRを活用したデータセットでは、LLMで利用するためのものと、LLMを構築するためのものとで品質の要件が異なり、両者を区別する必要があると述べました。
前者のLLMのコンテキストに入れるデータセットについては、分量を優先し、OCRテキストに誤りがあっても利用時にLLM側で対応できるとしました。一方、後者のLLMの学習用データセットについては、品質を優先し、テキストの誤りは手動・自動のいずれかで可能な限り事前に対応する必要があるとしました。さらに、学習の際には時代や種類に基づく資料の選定や、学習の目的に基づく文字セットの管理(コーパスをどのような文字で表すか)も重要だとしました。
LLMの利用事例:つくしチャットとつくし堂
つくしチャット
つくしチャットは、本やページの単位で古典籍の読みを支援するAIチャットで、2025年10月に大幅に更新しました。コンテキストには古文のOCRテキストを入れていますが、現代日本語で質問すると現代日本語で回答できます。商用・オープンのLLMを選ぶこともでき、LLM-jpのモデルも選べます。
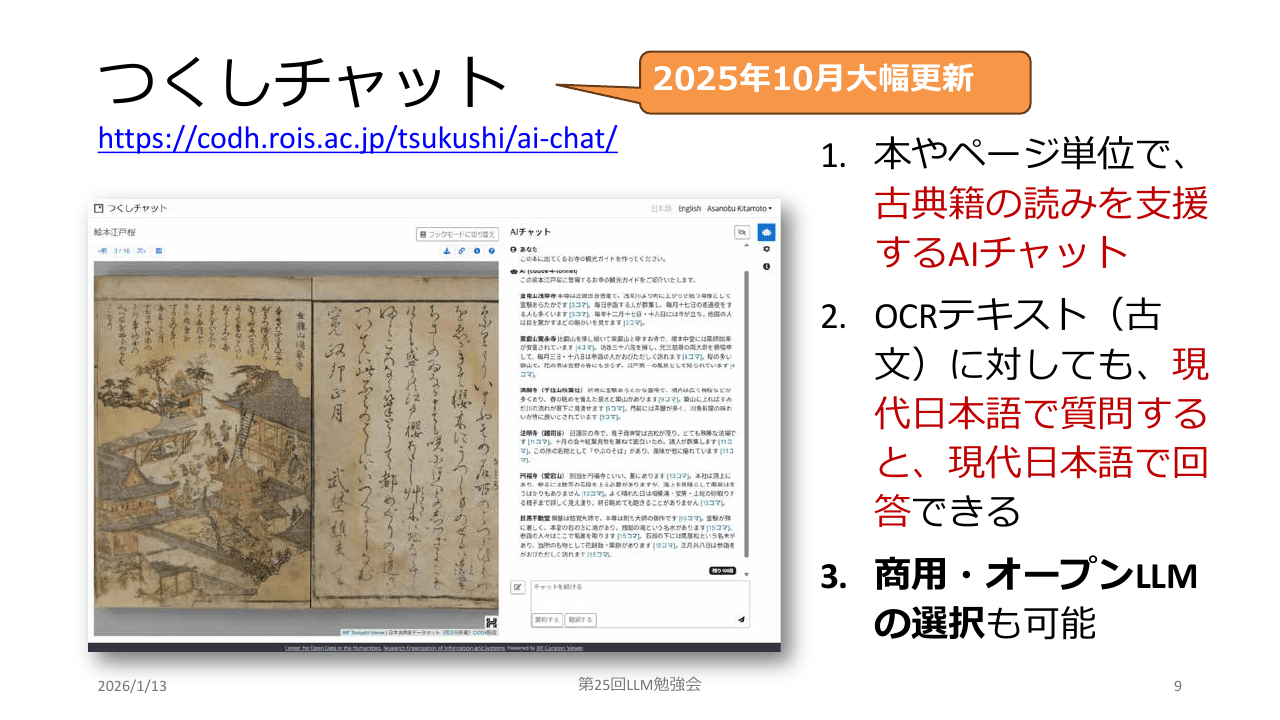
仕組みとしては、くずし字OCRしたテキストを、IIIF識別子の単位でアクセスできる形でデータベース(Content Service)に入れておきます。読んでいる本・ページのIIIF識別子のリストを送ると、その翻刻テキスト(古文)をコンテキストに、ユーザの入力をプロンプトに加えて、Chat ServiceがLLMで回答を生成します。北本氏は、仕組みは割と簡単で、標準的なやり方で十分に読めるものができると述べました。
つくし堂
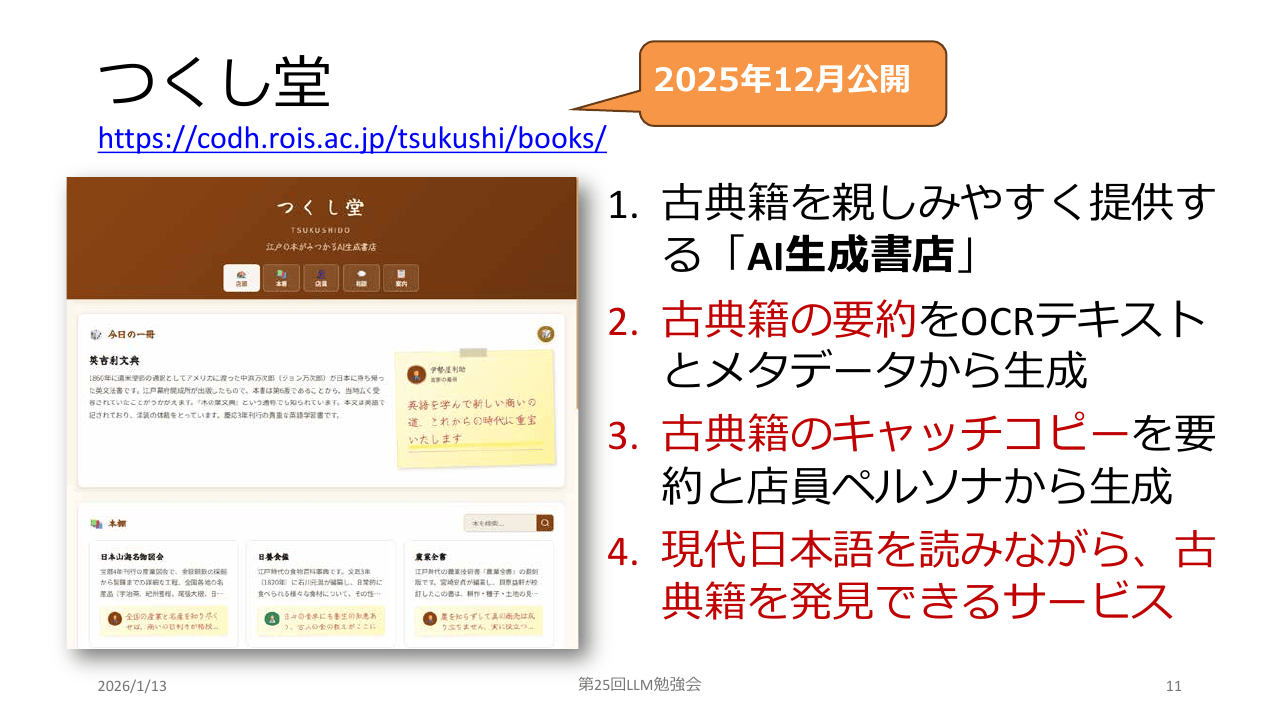
つくし堂は、2025年12月に公開した、古典籍を探すための「AI生成書店」で、コンテンツはすべてAIで作っています。要約はOCRテキストとメタデータから生成し、キャッチコピーは要約と店員のペルソナから、店員が勧める形で生成します。たとえば『自讃歌/苔莚』には「中世の言の葉が織りなす、風情深き連歌の世界」というキャッチコピーがついています。古文のままでは読めない本の中身を、現代文で親しみやすい形にすることで読みやすくしていると説明しました。
古文に用いるLLMの選択
北本氏のプロジェクトでは、基本的にClaude(Claude SonnetまたはClaude Opus)を使っています。古文に対してさまざまなモデルを評価した論文として、東山 翔平・大内 啓樹・橋本 雄太「中世・近世日本語資料の現代語機械翻訳における自動評価指標の検証」(じんもんこん2025論文集)を紹介しました。
LLMの学習事例:江戸時代の古典籍を学習した「からまる」
からまるは、江戸時代の古典籍を学習した大規模言語モデルです。研究代表者はカラーヌワット・タリン氏(Sakana AI)で、講演ではカラーヌワット氏のスライドを用いて説明しました。
からまるの回答
からまるに現代日本語で質問すると、古文風の言葉で答えます。AIに対して自分の名前を尋ねると「某が名を問せ給ふか我が名はからまるにて候」と答え、スマホについては「携帯用小文庫と申すものなり」と答えます。北本氏は、からまるは江戸時代の知識だけに限定しているわけではないが、できるだけ過去の語彙を使って概念を説明しようとし、現代語だけのLLMではなかなか考えつかない会話ができると述べました。
学習データの構成
からまるは、株式会社ELYZAが開発した、現代日本語に特化したElyza 8Bをベースモデルとして継続学習しました。学習データは合計2500万文字です。北本氏は、数千億文字が必要とされる一般の大規模言語モデルと比べると、かなり小さいデータだと述べました。
- みんなで翻刻データ(人間が作ったテキスト):1200万文字。江戸時代から昭和初期までのテキストのうち、メタデータで判断して江戸時代から明治中期までの資料を使いました。人間が作ったテキストなので非常に高品質と考えられると述べました
- CODHのくずし字データセット(人間が作ったテキスト):100万文字
- CODHの日本古典籍データセット(AIくずし字OCRが作ったテキスト):1200万文字。1008冊分のOCRテキストです
OCRテキストの選び方
OCRで作ったテキストは全体で3000冊ほどあり、そのうち1008冊を手動で選びました。北本氏は、選択の基準とその理由を次のように説明しました。
- くずし字データセットに字形が類似していること(RURIの学習データに近いとOCRの精度が高くなるため)
- 内容に専門用語が少ないこと(医療や辞書などを含まない)
- 漢文が少なく、漢字かな交じりであること(古文で答えさせたいので、漢文はあまり入れたくないため)
- 版本であること(手書きの写本よりも版本のほうがOCRの精度が高いと考えられるため)
OCRテキストの割合をこれ以上増やすと、からまるの回答に誤字が目立つようになることが経験的にわかっています。比較的品質がよいテキストを選んで学習したことで先の回答ができるようになったとし、コーパスの選び方が一つのポイントだと述べました。
歴史的日本語の文字とテキストの基礎知識:時代・種類・レイアウト
講演の後半では、カラーヌワット氏が作成した基礎知識のスライドを用いて、歴史的日本語の特徴を説明しました。
学習データと評価データの時代のずれ
LLM-jpの評価では大学入試問題を使っていますが、入試によく出る古典作品は主に平安時代・鎌倉時代のもの(『竹取物語』『伊勢物語』『源氏物語』など)です。一方、OCRによる古典テキストコーパスで最も多いのは江戸時代のものです。北本氏は、LLMに使われる日本語コーパスは主に江戸時代以降のものだと思うとしたうえで、江戸時代のテキストで学習して入試問題の精度が上がるかどうかは、時代のずれがどの程度影響するかに左右されるため、気をつけなければならない点だと述べました。
書体・本の種類・レイアウトによる違い
古典籍の文字には、楷書・行書・草書のように、だんだん崩されていく書体があり、北本氏は、これらを読めるようにすることが課題だと述べました。同じ時代の日本語でも、本の種類によって書き方が異なり、公文書や医学書は漢字で、非常にきれいな楷書で書かれ、物語や読み本はひらがなでかなり崩して書かれ、翻訳されたテキストや技術書はカタカナで書かれています。同じ本の中で漢文・漢字かな交じり・万葉仮名が混在する場合もあり、1冊の中に異なる書き方が出てくるため、本を単位にOCR手法を切り替えるのが難しい場合もあるとしました。
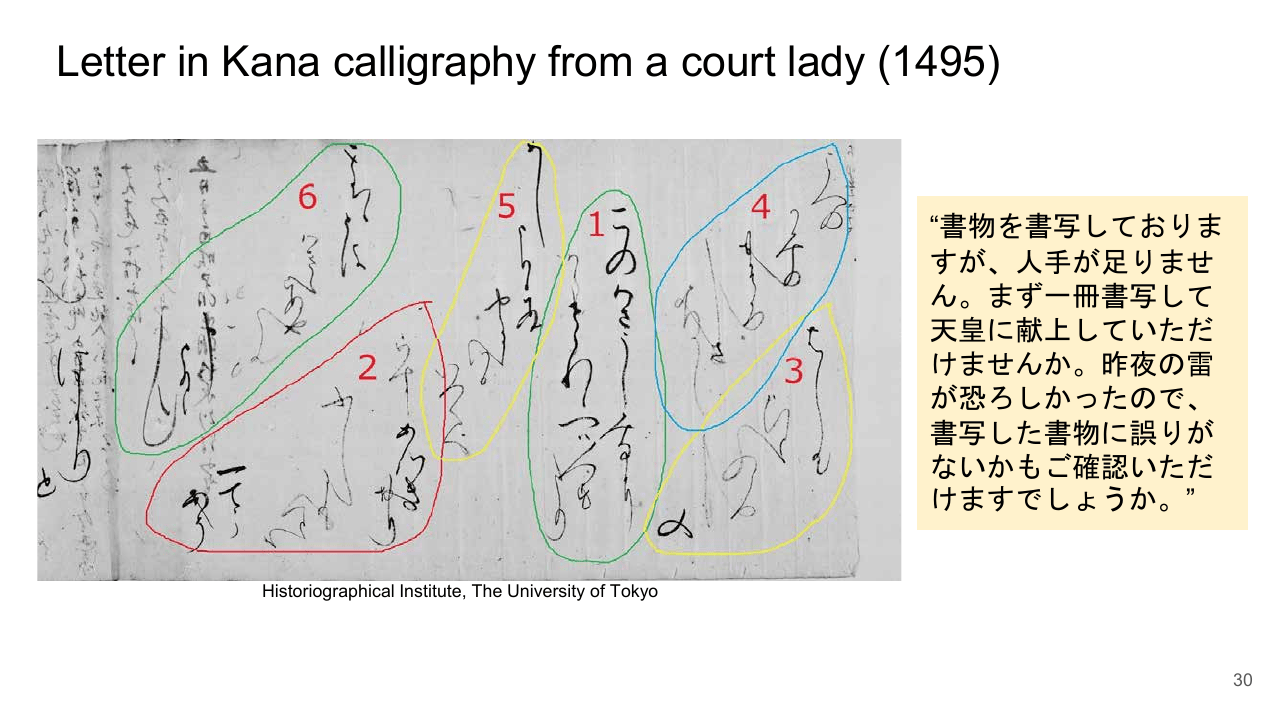
講演では、古典籍のレイアウトの問題として、1495年の書状(Letter in Kana calligraphy from a court lady)を例に、行があまり明確でない紙面を1から6の順に読むという読み順を示しました。これは散らし書きというかなり特殊な例であるものの、一般にレイアウトはかなり自由に書かれている面があると述べました。その理由として、木版印刷でも、手で書き写す写本でも、レイアウトを自由に決められることを挙げ、読み順を自動で判定するのはなかなか難しいとしました。
歴史的日本語の文字とテキストの基礎知識:翻刻・文字・校訂・句読点
翻刻と文字の問題
翻刻(transcription)は、くずし字で書かれた資料を読んで現代日本語の文字を入力する作業で、翻訳とは異なり、テキスト化の作業を指します。北本氏は、翻刻には文字に関して次のような難しいところがあると述べました。
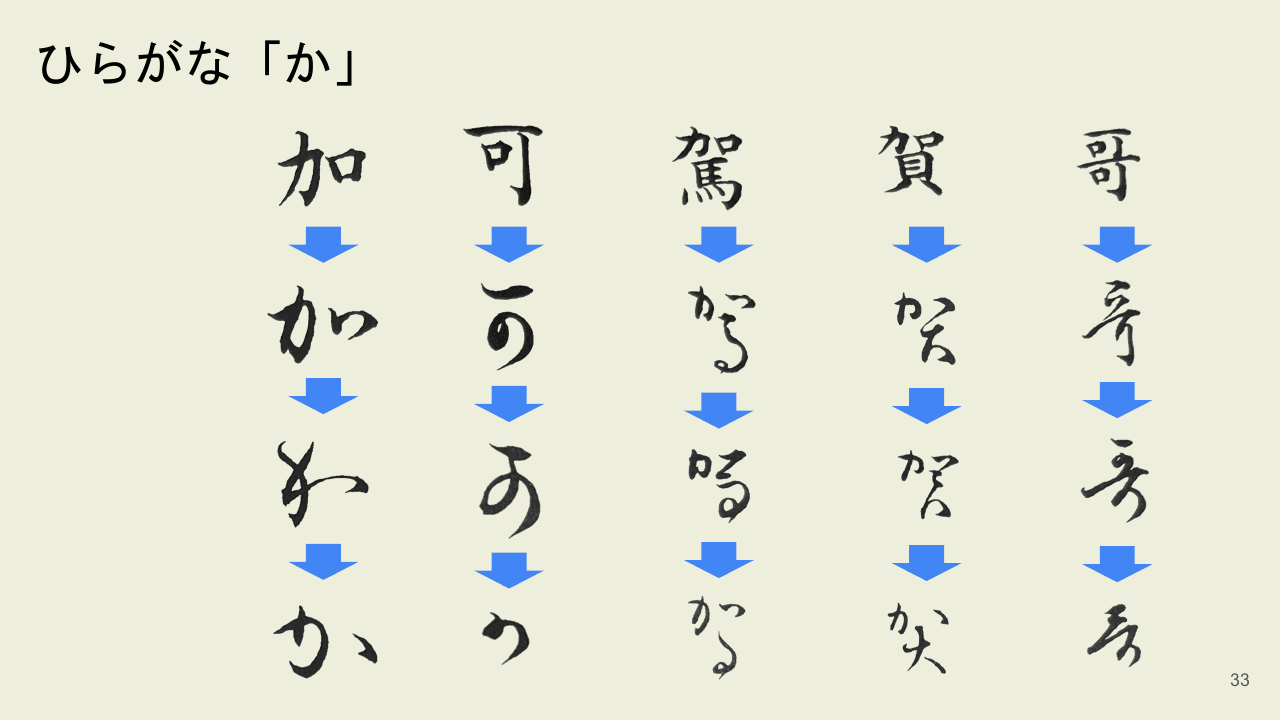
- 変体仮名:過去には「加・可・駕・賀・哥」の5つの字母を崩した文字がすべてひらがなの「か」でした。1900年の小学校令で小学校で教えるひらがなが決まり、それ以外を教えなくなったため読めなくなった文字を、変体仮名と呼びます。戸籍などに一部残っていることもあってUnicodeにも登録されているものの、変体仮名のUnicodeで翻刻するとなかなか活用が難しいため、通常は現代のひらがなのUnicodeで翻刻すると述べました
- 異体字:「事」という文字には多くの異体字と、それを崩した形があり、すべて「事」と認識しなければなりません
- 似た字形・同じ字形:くずし字認識モデルが最もよく間違えるのは、ひらがなの「は」、カタカナの「ハ」、漢字の「八」や、「ば」「バ」です。文脈を見れば区別できるものの、文字単位だけではなかなか区別がつかず、非常に認識精度が下がると述べました。また「見」は、「みそ汁」ではひらがなの「み」として、「見る目」では漢字の「見」として使われ、同じくずし字でも現代日本語では違う文字になります
校訂本文と句読点の問題
山東京伝『箱入娘面屋人魚』を対象として、以前にOpenAIのGPT-4で行った実験の結果を示します。OCRによる翻刻テキストを入れると、古い日本語の表現なので翻訳できないという回答でしたが、人間が校訂したテキストを入れると現代語訳ができました。校訂本文とは、句読点を補う、濁点をつける、歴史的仮名遣いを現代かなにする、ひらがなのところを漢字にする(例:「かむた」を「神田」にする)といった処理で読みやすくしたものです。北本氏は、その後のLLMの進歩により、最新のLLMであれば翻刻テキストのままでも理解できるようになったと述べました。そのうえで、教科書や入試で通常使われるのは校訂された文章であり、OCRテキストか校訂テキストかでわかりやすさがだいぶ違うとし、この差をどうするか、校訂という作業をどう捉えるかが一つのポイントになるとしました。
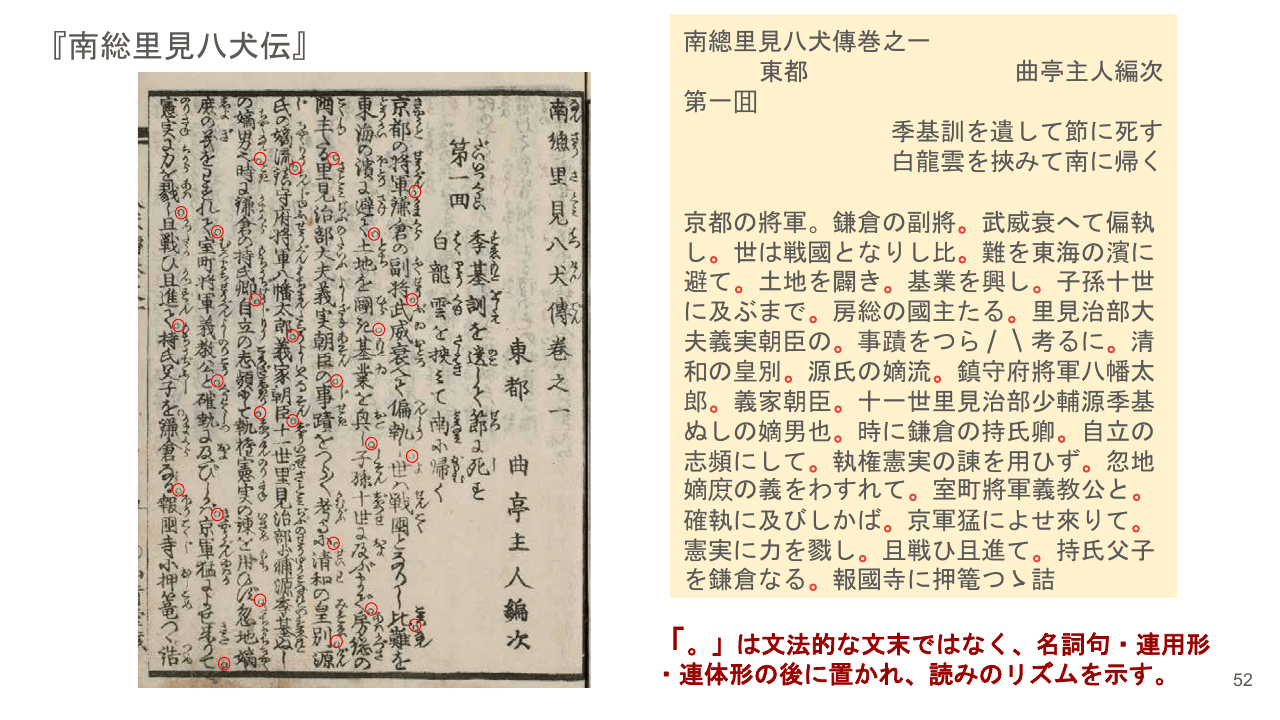
句読点にも歴史があり、奈良・平安時代は漢文訓読の記号「ヽ」、鎌倉〜室町時代は「・」または空白が使われ、江戸初期(1636年〜)に版本で「・」「。」が現れ、明治時代に文部省によって「、」「。」が標準化されました。江戸時代の本である『南総里見八犬伝』には句読点がありますが、現代とは違います。その「。」は文法的な文末ではなく、名詞句・連用形・連体形の後に置かれて読みのリズムを示すものです。
今後に向けて
どうデータセットを作り、何を評価するか
北本氏は、テキストの多様性を考えると、単一のOCRですべてをテキスト化するのは得策ではなく、既存の商用・オープンなOCRやVLMにも活用の余地があり、特に漢文についてはおそらく中国系のモデルが強いと述べました。また、文字認識とレイアウト認識は全く異なる問題であり、文字の読み順の推定は依然として重要な課題だとしました。研究者や出版社が持つ高品質な翻刻データを収集して学習データセット化する活動も、今後求められるのではないかと述べました。
評価については、からまるのような古文の出力はネイティブな書き手が存在しないため評価が困難であり、古文の入試問題は古典籍の学習データの量的な中心から外れているため、評価データセットの多様化が望ましいとしました。教育の中心である平安時代の古文はテキストが少なく1000年以上研究されているため、AIで新しい発見をするのは難しいのではないかとし、研究DX(AI for Humanities)の観点では、膨大な江戸時代の古文の読み解きができるとインパクトがあるのではないかという考えを示しました。
何を目指すか
古文や漢文を現代日本語とは別の言語と捉えるとゴールは翻訳タスクになるものの、翻訳タスクだけでよいのかは考えなければならないと述べました。文化や歴史の連続性を考えると、通時的な変化のモデル化も面白い課題だとし、ナレッジカットオフを過去にシフトして過去の世界を再現する研究もあるものの、その有用性は未知だとしました。そのうえで、古文を学習することは過去の知識と現在の知識を橋渡しすることに価値があるのではないかと述べました。
講演では議論しなかった課題として、NDL古典籍OCRとRURIの比較、Post-OCRのテキスト修正の可能性、OCRテキストと校訂本文の位置づけ、書写の変異を考慮した重複テキストの検出、テキスト年代の推定、マルチモーダル基盤モデルの可能性(Sakana AIが開発するEvo Ukiyoeモデル等)の6つを挙げました。
講演情報
- イベント:第25回LLM勉強会 - LLM-jp
- 講演日:2026-01-13
- 講演者:北本 朝展(国立情報学研究所/ROIS-DS人文学オープンデータ共同利用センター(CODH))
- 講演資料:歴史的テキストとLLM:コーパスの構築と活用
関連リンク
- 北本 朝展 (Asanobu Kitamoto) - マイポータル - researchmap
- HumanitiesThroughDDPS
- つくしプロジェクト
- Metomくずし字認識サービス(文字単位)
- みを(miwo):AIくずし字認識アプリ
- 古典籍資料のOCRテキスト化実験(令和4年度~)
- つくしチャット
- つくし堂
- 歴史的テキストとLLM:コーパスの構築と活用
この記事は、講演記録を基に生成AIを利用して作成したユースケース記事です。