はじめに
ROIS-DS人文学オープンデータ共同利用センター/国立情報学研究所の北本朝展氏が、美術作品から顔の部分を集めた「顔貌コレクション(顔コレ)」を軸に、IIIFとAIという2つの技術的な進展が美術史研究をどう変えるかを解説した講演です。画像を活用した人文学研究の大規模化や、人文学と情報学が協働する研究の形に関心のある方に役立ちます。
セミナーの背景と趣旨
顔貌表現の比較による様式分析は美術史における基本的な研究手法であり、これを大規模化する環境が整ってきたことがこのセミナーの出発点です。近年の進展は主に3つあります。第一に、画像共有のための国際的方式であるIIIFが普及し、ツールの開発も進みました。第二に、様式分析の基礎となる大規模データセットとして顔貌コレクション(顔コレ)などがオープンデータとして利用可能になりました。第三に、AI(人工知能)を活用することで、研究対象となる画像コレクションの構築を半自動化できる可能性も見えてきました。
東大とCODHの共同研究チームは、これらの技術を「遊行上人縁起絵巻」に適用し、従来の研究の典型的な規模をはるかに上回る顔貌画像コレクションを用いることで、絵師ごとの様式の違いを明らかにしました。現在は樹木や水景など背景の様式分析にも取り組む計画があります。セミナーでは、この研究で用いた手法やツールを紹介するとともに、画像を活用した人文学研究を大規模化するための知見を共有します。
顔貌コレクションとデータ駆動型人文学
顔貌コレクション(顔コレ)は、絵本や絵巻のデジタル画像から顔の部分だけを切り抜いて集めたデータセットで、その構築と分析の進め方には、研究手法そのものをデジタル化する考え方が表れています。第一段階では、デジタル画像から顔の部分を切り抜き、「山伏」といったメタデータを付与して網羅的なデータセットを作ります。第二段階では、デジタルツールを用いてデータセットを分析・可視化し、新たな発見につなげます。こうしたデータセットは一度作れば、顔の様式を比較する美術史研究のほか、顔を自動的に認識する研究や、実際には存在しない絵巻風の顔をGANによって作り出す「機械の創造性」の研究など、さまざまな目的に使えます。
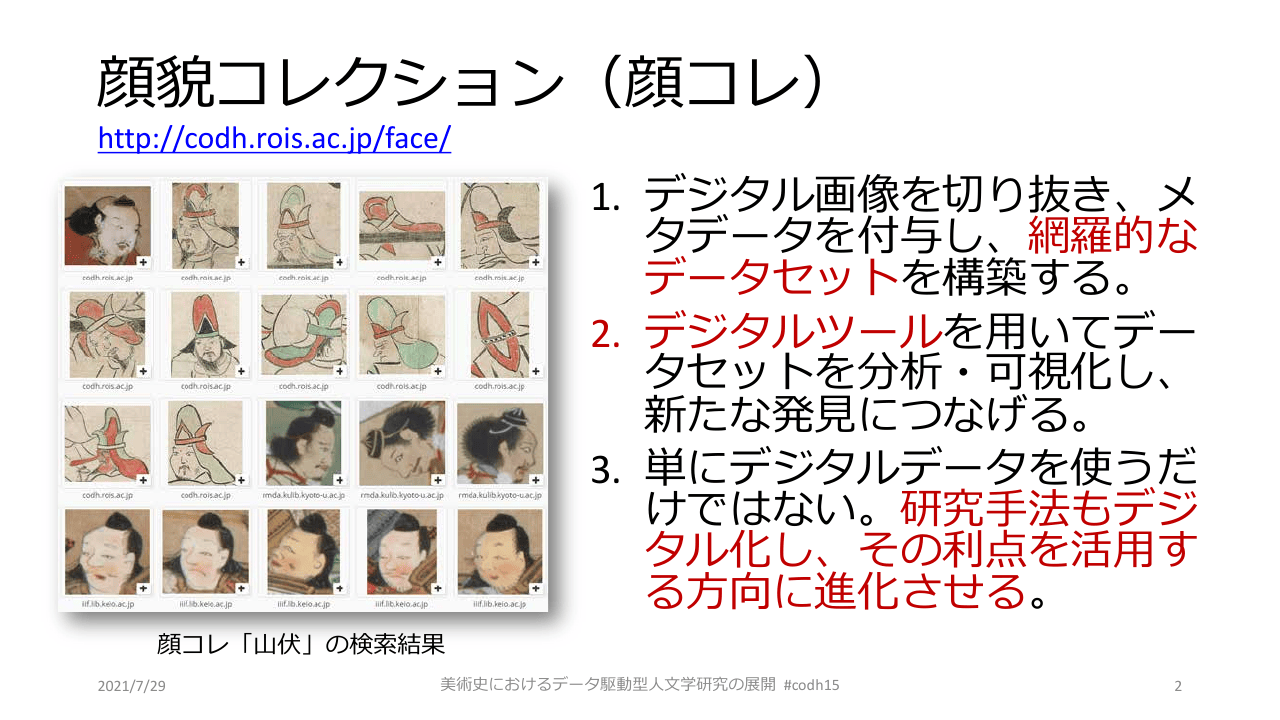
北本氏が強調したのは、単にデジタルデータを使うだけではないという点です。同じ作業は紙と糊などでも行えますが、デジタルの利点を活用する方向に研究手法自体を進化させることに大きな違いがあります。
このような研究手法をデータ駆動型人文学と呼びます。データを基盤とする新しい手法により人文学の研究手法を革新し、人文学的に新しい知識を得ることを目標とするもので、データの共有やエビデンスに基づく検証といった新しい文化を人文学に導入することも課題になります。一方、人文学から生み出される大規模データが人文学の外側に影響を与える方向は人文学ビッグデータと呼ばれ、構造化や解釈の技術を分野を超えて共有することで他分野の革新につなげます。北本氏は、データ駆動型人文学を広い意味でのデジタルトランスフォーメーションの一つの表れと位置づけられると述べました。
データ駆動型人文学研究の類型
データ駆動型人文学研究の始まり方には、いくつかの型があります。人文学者のリサーチクエスチョンをきっかけに情報学者がデータ化やシステム化の手法を練る型、情報学者の技術的提案をきっかけに人文学者が活用を進めシステムの課題を出す型、両者がアイデアを議論しながら新しい研究課題と技術的な解決策を探す型です。さらに、ソフトウェアエンジニア、データクリエイター、データキュレーター、デザイナーなどの専門人材を含むチームを構成し、協働によって研究の質と量を向上させる形もあります。
始まり方は多様ですが、一人で進める研究ではなく、さまざまな専門人材が協力する点が従来型の研究と大きく異なると北本氏は指摘しました。
IIIFとキュレーションによる画像収集
顔コレのようなデータセットを作る基盤となるのが、IIIFとキュレーション機能です。
IIIFとは
IIIF(International Image Interoperability Framework、国際的な画像配信方式)は、世界中のミュージアムやライブラリで使われるようになってきた画像共有の方式です。さまざまなWebサイトを一つのブラウザで見られるのと同じように、全世界のIIIFサービスを一つのIIIFビューアで閲覧できます。ビューアにはMiradorやUniversal Viewerなどがあり、CODHが開発するIIIF Curation Viewerもその一つです。IIIFの詳しい資料は第14回CODHセミナー - IIIF Curation Platform利活用レシピ100連発にまとまっています。
キュレーションとIIIF Curation Platform
IIIF Curation Viewerの特徴的な機能がキュレーションです。キュレーションとは、もともとミュージアムにおいて資料の収集や作品の展示などの活動を指す言葉で、あるテーマに沿ってコンテンツを集め、適切な順番に並べ、新たなコンテンツとして提示・共有するという流れを、IIIFのサービスに対して自由に行えるようにしています。アナログの時代にカメラやコピー機で複製し、ハサミと糊で一覧を作っていた作業が、デジタルで簡単にできる点がメリットです。実例に、末摘花の描かれ方を集めた不美人の描き方—「末摘花」や顔貌データ:イギリスの肖像があります。
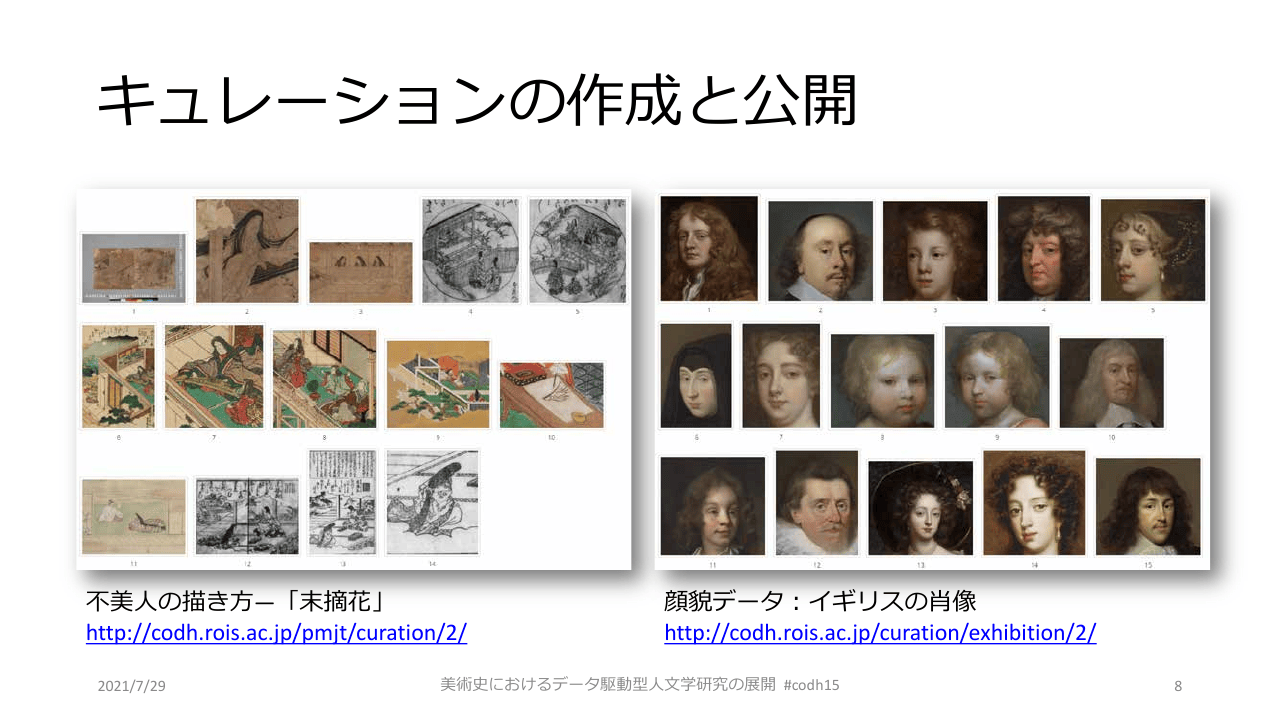
これらのソフトウェア群を含む基盤がIIIF Curation Platform (ICP)です。ICPは、テーマ別の画像コレクションを利用者が独自に作成し公開できるようにし、画像提供者以外が公開する画像サービスの呼び出しや、利用者独自の付加情報のオーバーレイ表示(地図上にマーカーを打てる江戸マップがその例です)も可能にしました。画像を収集し、処理し、公開するワークフロー全体を支援する基盤として、IIIF画像の新たな利活用を開拓する役割を果たしています。ウェブブラウザ上で動作するソフトウェア7点をはじめとするコンポーネント群はいずれもオープンソースで、使うだけであれば無償で利用できます。
機械学習とは何か
機械学習は、入力と正解の組を与えてモデルを調整していく技術であり、データセットと正解が揃えばデータ駆動型人文学を推進する強力なツールになります。機械学習(machine learning)とAI(artificial intelligence)は厳密には異なりますが、一般にAIと呼ばれるものは現在では機械学習を指すことが多くなっています。機械学習には教師あり学習、教師なし学習、強化学習などがあり、目的に応じて使い分けます。
現在よく使われるのは教師あり学習で、出力が正解でなければモデルを調整する作業を繰り返し、多数のパラメータを自動的に調整して正答率を高めていきます。モデルの内部で何が起こっているかを把握することは難しく、ブラックボックスと言われることもありますが、入力に対して正解が出ればよいと割り切って使うのが最近の使い方だと北本氏は説明しました。
例として挙げられたのが日本古典籍くずし字データセットです。画像上の座標にどの文字があるかを正解として学習させると、くずし字画像から文字を認識できるようになり、条件がよい場合には95%以上の精度が得られます。ただし学習していないタイプの画像を与えるとまったく認識できないため、何を学習し、何を正解できるようになっているかを常に考えながら使うことが大切です。
機械学習による顔検出
顔コレを学習データとして用いると、未知の絵巻からも顔を自動抽出できるようになります。画像のどこに顔があるかをひたすら学習させる方法で、R-CNNというモデルを用いて顔画像を自動的に切り取るところまで、現在の技術は到達しています。
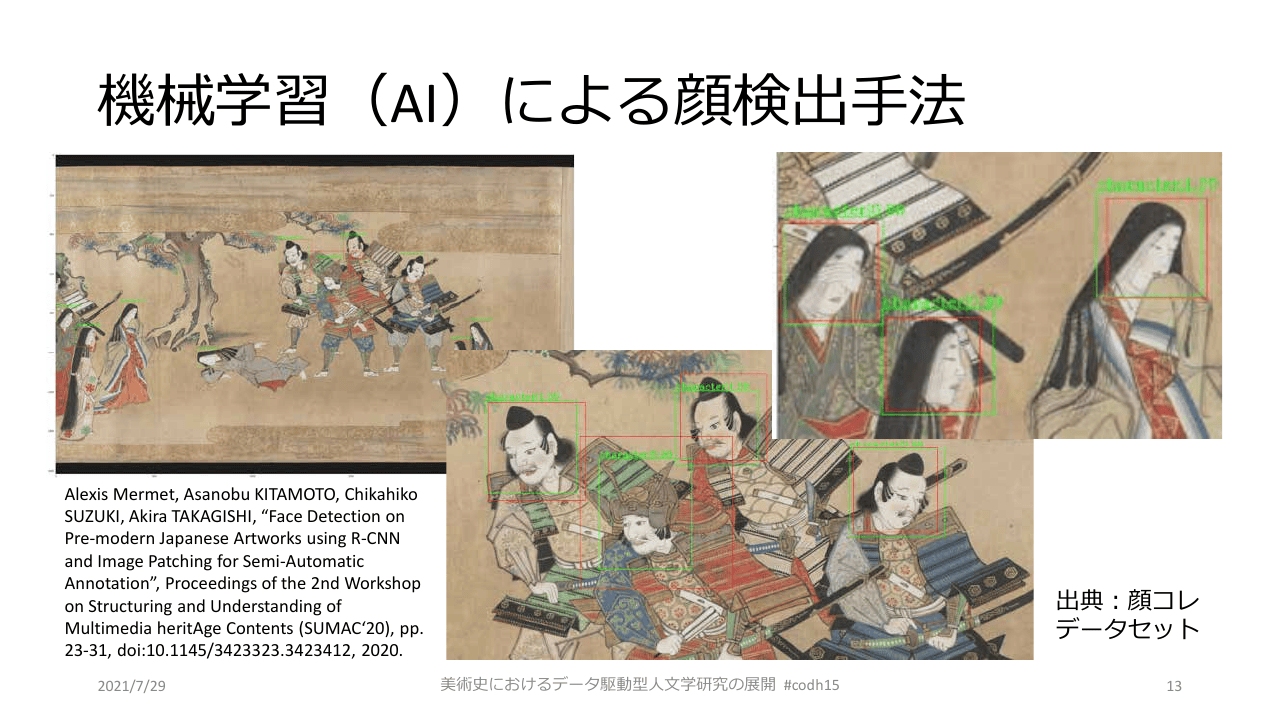
顔コレデータセットを対象とした場合、80%程度の顔を自動検出できました。さらに、顔コレデータセットで学習したモデルを、時代が異なる作品に適用した場合でも70%程度の顔を自動検出できました。精度は下がるものの、かなりの数の顔が自動検出できることが分かっています。
たくさんの顔が描かれた絵巻から人手で顔の位置のデータを作る作業は負担が大きいものですが、3分の2の検出を機械に任せられれば、人間が顔を切り取る作業量を3分の1に短縮できます。より多くの作品を分析できるようになれば、エビデンスの信頼性が向上し、研究を深めることにつながると期待されます。
AIの役割と留意点
顔コレにおいて機械学習に最も価値があるのは、顔の切り抜きという「作業」を支援することで労力を大幅に軽減できる可能性がある点だと北本氏は述べました。データの解釈そのものは専門家が行う「精読」に基づきますが、機械学習でデータセットの規模を拡大することで、従来より広い範囲での精読が可能になります。
一方、データの解釈も機械が支援する方向は、デジタルヒューマニティーズで「遠読(Distant Reading)」と呼ばれる手法に属します。機械が結果まで出してくれることには新たな可能性が広がる反面、方法論の危うさも共存しており、リスクを認識しながら進める必要があります。
北本氏が繰り返し注意を促したのは、AIの結果が学習データに依存するという点です。AIが神様のお告げのように正しい答えを出してくれるというのは幻想であり、あくまで学習したことを出力しているにすぎません。結果を盲信して都合のよいエビデンスとして使うのではなく、新たな解釈を考える手がかりとして使うのがよいというのが北本氏の見解です。
顔画像データセットの展開とedomi
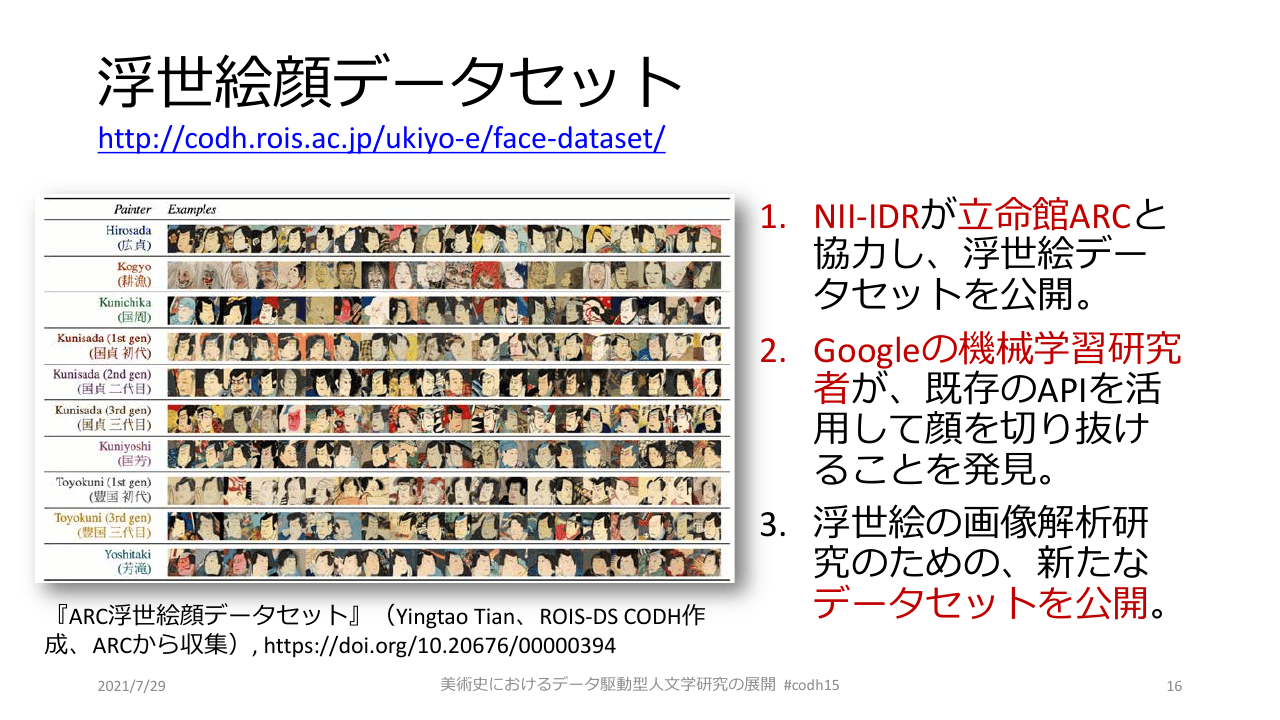
顔画像のデータセットは中世の絵巻以外にも広がっており、公開されたデータを見せる場も整えられています。浮世絵顔データセットは、江戸の浮世絵を対象としたデータセットです。NII-IDRが立命館大学アート・リサーチセンター(ARC)と協力して浮世絵データセットを公開しており、Googleの機械学習研究者が既存のAPIを活用して浮世絵から顔の部分を切り取れることを発見しました。CODHはこれを用いて、ARCの浮世絵データから顔のコレクションを作成し、浮世絵の画像解析研究のための新たなデータセットとして公開しています。
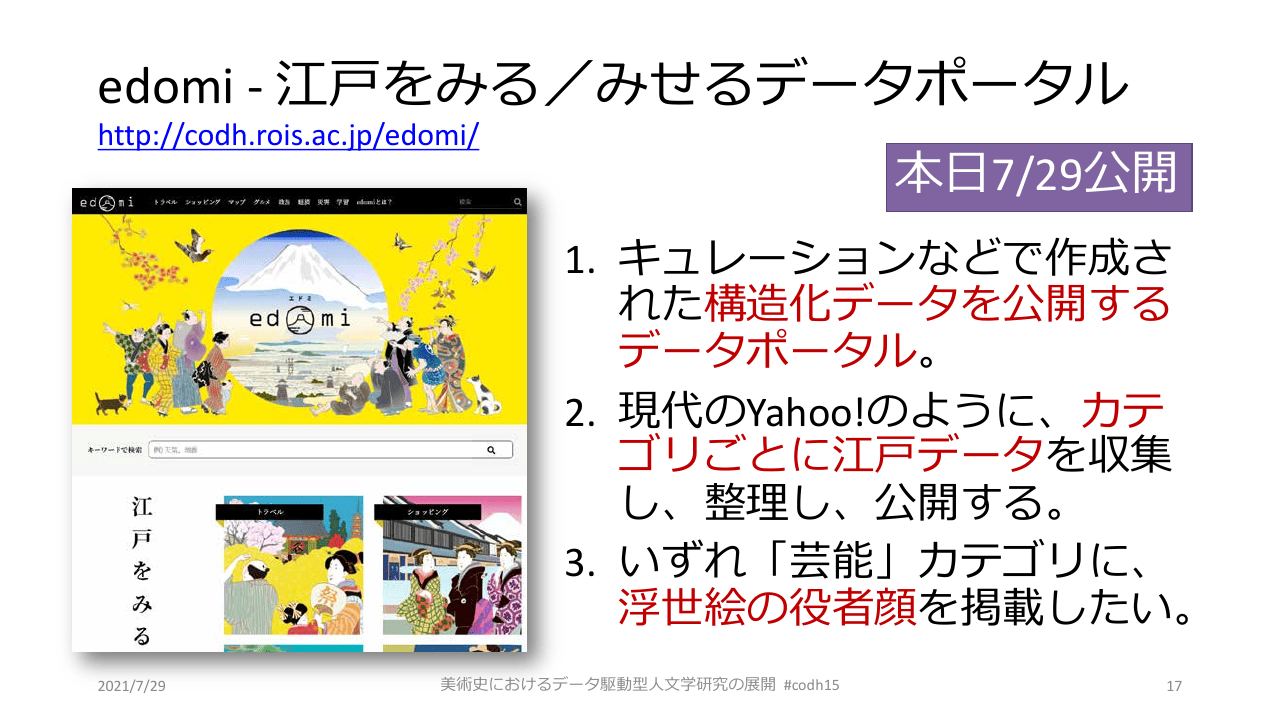
講演当日に公開されたのがedomi - 江戸をみる/みせるデータポータルです。キュレーションなどで作成された構造化データを公開するデータポータルで、現代のYahoo!のように、カテゴリごとに江戸のデータを収集し、整理し、公開します。北本氏は、役者の顔を自動的に切り抜けるのであれば、いずれ「芸能」カテゴリに浮世絵の役者顔を並べたいという構想を語りました。
知見と今後の展望
IIIFとAIという2つの技術的な進展が合流したことで、美術史研究でも大規模データを扱えるようになりました。IIIFの相互運用性は、日本でも他の国でも同じ技術でデータを集められる形で、組織横断的かつ全球的な大規模データ収集を可能にしました。AIの高性能化は、表層的な内容分析や物体抽出の一般化と大規模化を可能にしました。各種ツールも充実したことで大規模データを扱う時代が訪れ、そのなかでは、定性的な方法と定量的な方法、精読と遠読など、目的に合った研究手法を使い分ける知識がこれから重要になります。
今後の展望として、北本氏は4点を挙げました。第一に、美術史研究の大規模化の背景には多くのミュージアムやライブラリによる高解像度画像の公開があり、データ公開の努力に対する感謝を忘れずに研究を進めるべきだという点です。第二に、データ駆動型人文学研究はチーム型になっていくという点です。人文学の共同研究では地域や時代、作品で分担することが多かったのに対し、データを作る、学習させる、解釈するといった役割で分担するチームは新しい挑戦になります。第三に、人文学側はリサーチクエスチョンを明確化し、研究の方法論をデジタルに合う形に進化させることです。第四に、情報学側は分野専門家とコミュニケーションを取り、問題の抽象化と手法の有用性に焦点を合わせて研究を進めることです。
講演情報
- イベント:第15回CODHセミナー - IIIFとAIで変わる美術史研究 - 大規模顔貌データの様式分析から読み解く日本中世絵巻
- 講演日:2021-07-29
- 講演者:北本 朝展(ROIS-DS人文学オープンデータ共同利用センター/国立情報学研究所)
- 講演資料:人文学研究データリポジトリ(doi:10.20676/00000395)
- 講演動画:YouTube
関連リンク
- 顔貌コレクション(顔コレ)
- ROIS-DS人文学オープンデータ共同利用センター(CODH)
- IIIF Curation Platform (ICP)
- 第14回CODHセミナー - IIIF Curation Platform利活用レシピ100連発
- 不美人の描き方—「末摘花」
- 顔貌データ:イギリスの肖像
- 日本古典籍くずし字データセット
- 浮世絵顔データセット
- edomi - 江戸をみる/みせるデータポータル
この記事は、講演記録を基に生成AIを利用して作成したユースケース記事です。